Grafana 仪表盘
dcctl install 部署的监控栈为每个实例提供十个 Grafana 仪表盘:一个回答“一切都在运行吗?”的总览,七个阶段仪表盘,分别对应消息从设备到送达通知所经过的各个阶段,外加支撑这些阶段的平台层,以及两个面向可选的 Sparkplug 与 LwM2M 服务的仪表盘。每个仪表盘用于回答一个问题,并链接到你接下来会打开的仪表盘。边缘代理运行在集群之外,改用它自己的仪表盘文件。
仪表盘上的所有内容都来自服务已经导出的指标(参见指标参考),以及监控栈采集的标准 Kubernetes、数据库和消息代理序列。无需额外开启任何东西。
本页的截图取自一个单节点本地实例,承载来自四个租户的稳定合成负载:遥测、由规则触发和清除的告警,以及由设备应答的命令。时间使用 UTC;仪表盘截图覆盖 30 分钟,中断截图覆盖 15 分钟。
找到仪表盘
打开 Grafana,找到文件夹 devicechain-<实例>。每个实例都有自己的文件夹和自己的一份仪表盘,标题为 DeviceChain — <名称> [<实例>]。仪表盘只读取所属实例的数据:没有实例选择器,一个实例的仪表盘无法显示另一个实例的数据。
每个仪表盘顶部都有 DeviceChain boards 菜单,列出该实例的所有仪表盘;总览末尾有一行指向各阶段仪表盘的链接。唯一需要你选择的是数据源,即监控栈安装的 Prometheus。
每个仪表盘都以同一张 Firing alerts 表开头。它列出此刻正在为该实例触发、且属于该仪表盘所在阶段的告警,因此阶段正常时阶段仪表盘是安静的。表为空表示没有告警触发,Grafana 会将其显示为 No data。该表读取实例的 Prometheus 规则,如果这些规则没有安装,表会一直为空。总览列出全部告警,所以没有任何阶段仪表盘匹配的告警仍然能在总览中看到。
如何阅读面板
每个面板都有说明:把鼠标悬停在面板角落的小 i 上即可。它会说明面板统计什么、正常值是什么样、异常时该怎么做。以下约定适用于所有仪表盘。
- **指标卡的颜色表示含义。**绿色表示健康,黄色表示尽快查看,红色表示需要处理。名称含“over the range”或“selected range”的指标卡统计你所选时间范围内发生的情况,需要回溯更远就拉长时间范围;没有这类字样的指标卡显示当前值。
- **应该保持为零的指标卡显示
0,而不是“No data”。**当计数没有可统计的内容时,仪表盘有意用零代替。面板显示“No data”则是在告诉你该序列尚未上报,这与什么都没发生不同。
积压面板,以及读取方宕机时它们显示什么
这些积压(backlog)面板统计等待交给读取方的消息,加上已经交出但尚未确认的消息。单独的待交付或在途面板只统计其标题所指的部分。它是平台中最有用的早期预警,因为读取方比生产方慢时,会在任何故障出现之前很久就开始落后。积压的含义及其测量方式参见持续落后的消费者。
每个读取服务都会上报自己的积压,但已经停止的服务无法上报任何东西。读取方崩溃、正在重启或被缩容到零的时候,恰恰最需要这个数字,而此刻变成空白的仪表盘毫无用处。因此积压面板有两个来源,按顺序取用:
- 读取方自己的上报,在读取服务运行时使用。
- 消息代理自己对同一读取方的计数,取自代理的指标,在读取方不上报时使用。
可以这样回退的面板会在说明里写明(“While the reading service is down this shows the message broker's own count”)。两个来源统计的是同一批消息,因此一个接替另一个时,面板上的曲线保持连续。
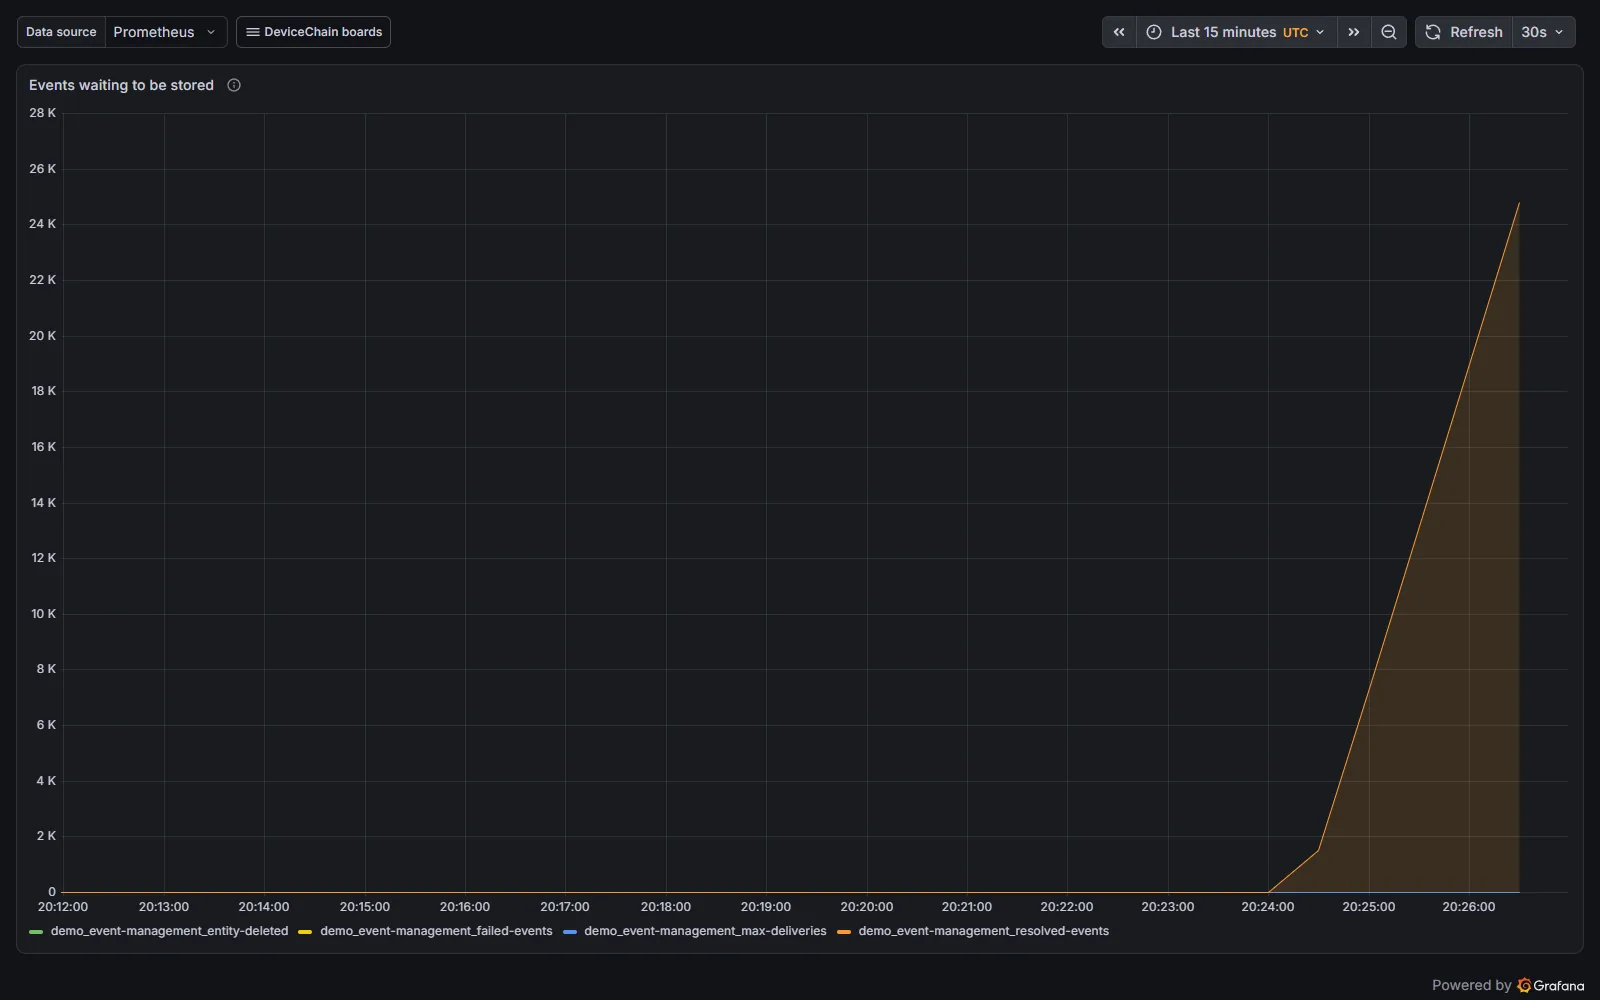
event-management(负责存储事件的读取方)被缩容到 0 约两分半钟后的 Events waiting to be stored。读取方宕机时无法上报,因此这条曲线来自代理对同一批消息的计数,并随着事件不断到达而上升。
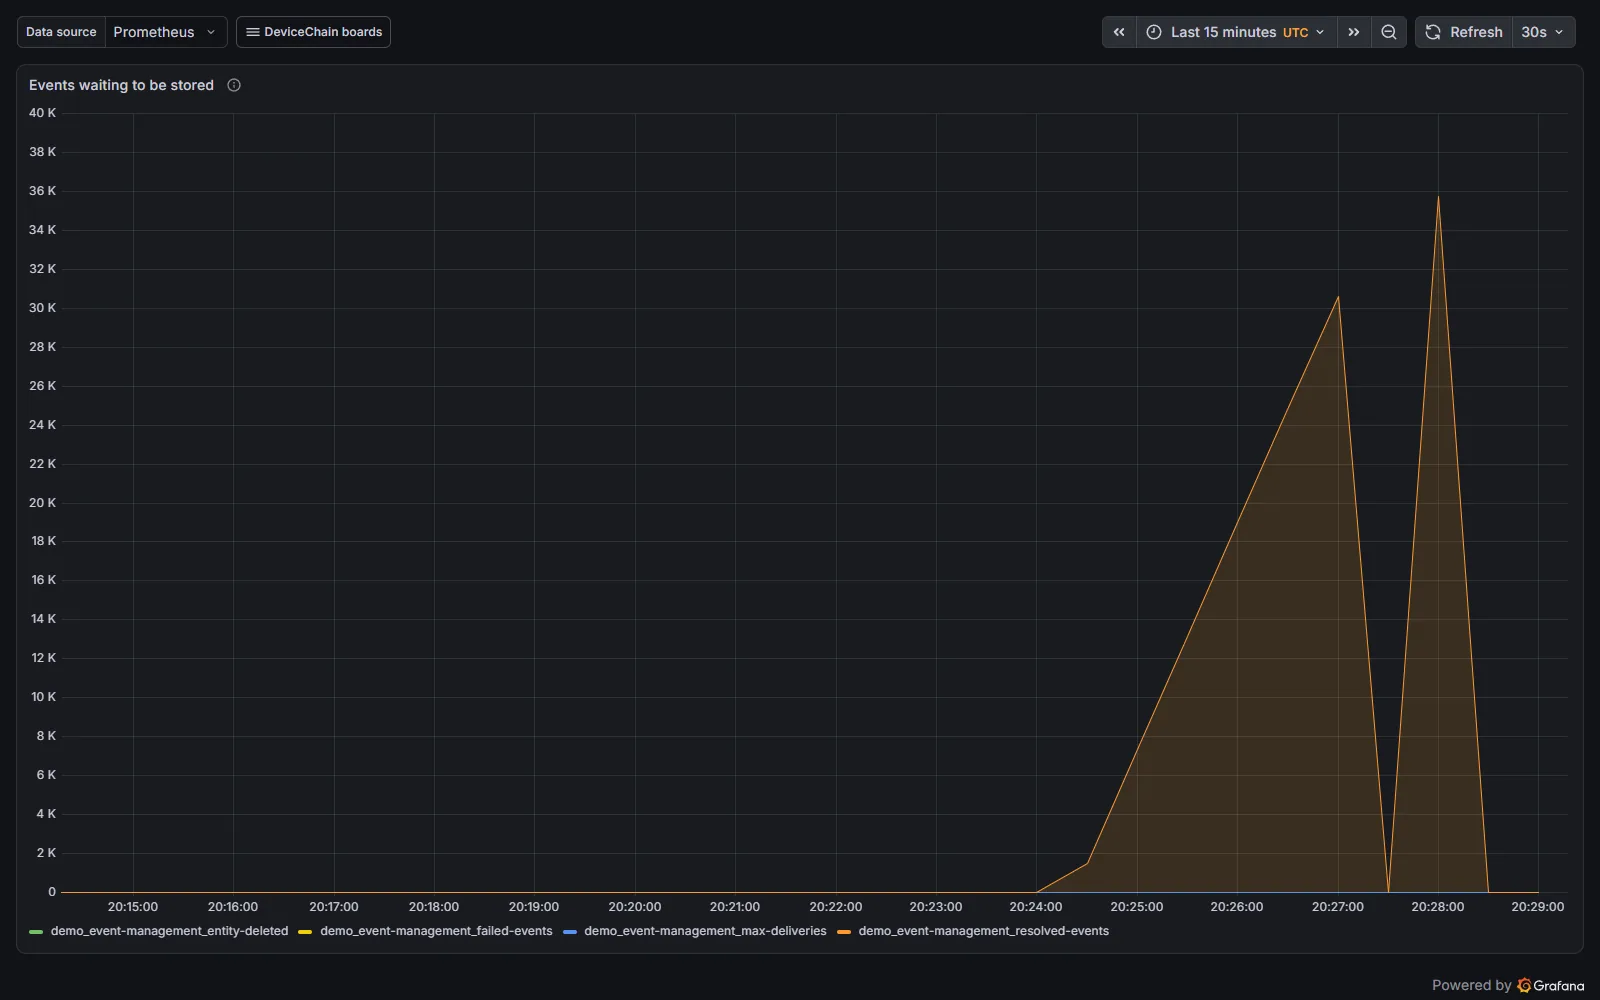
event-management 扩回 1 个副本后的同一面板。读取方启动后约一分钟内积压清空。代理回退同时统计等待中和处理中的事件,直到读取方再次上报。
共有十九个面板带有代理回退:
- **Messaging:**Unread backlog per reader、Handed out, not yet acknowledged 和 Share of stream capacity left unread。
- **Ingest:**Backlog against its limit、Backlog and stream fill over time、Arriving vs backlog growth(其积压增长曲线)和 Capture backlog in messages(其第一条线)。
- **Event processing:**Consumer lag (undelivered)、In-flight (delivered-unacked)、Consumer backlog、Derived-event backlog 和 Consumer unread backlog (share of stream capacity)。
- **Delivery:**Waiting to be sent、Dispatch backlog、Notification backlog 和 Update report backlog。
- **Persistence:**Events waiting to be stored 和 Updates waiting to be applied。
- **总览:**Largest backlog share 指标卡。
Messaging 的 Messages waiting to be redelivered 始终是代理自己的计数,因此没有可回退的读取方来源。
有两点限制需要了解:
- **回退依赖代理的指标。**监控栈会采集代理,所以默认安装下回退可用。如果你使用自己的 Prometheus 且没有采集代理,读取方停止时积压面板会像以前一样变成空白。
- **丢失计数器没有回退。**统计流在读取方读取之前就丢弃的消息的指标卡和曲线由读取方自己计数:Ingest 的 Messages lost before being read, over the range 和 …, any consumer,以及 Capture backlog in messages 的第二条线(未读缺口);Messaging 的 Messages lost unread (range) 和 Messages lost unread /s;以及总览的 Messages lost。读取方宕机期间这些指标卡显示 0,这并不能证明没有丢失。中断期间被丢弃的消息只有在读取方恢复后才会被计入,作为下限,并记在其恢复的时间点。中断期间请根据仍然有效的 Share of stream capacity left unread 判断风险:达到 100% 时,流开始丢弃读取方尚未看到的消息。参见消费者从未读取的消息。
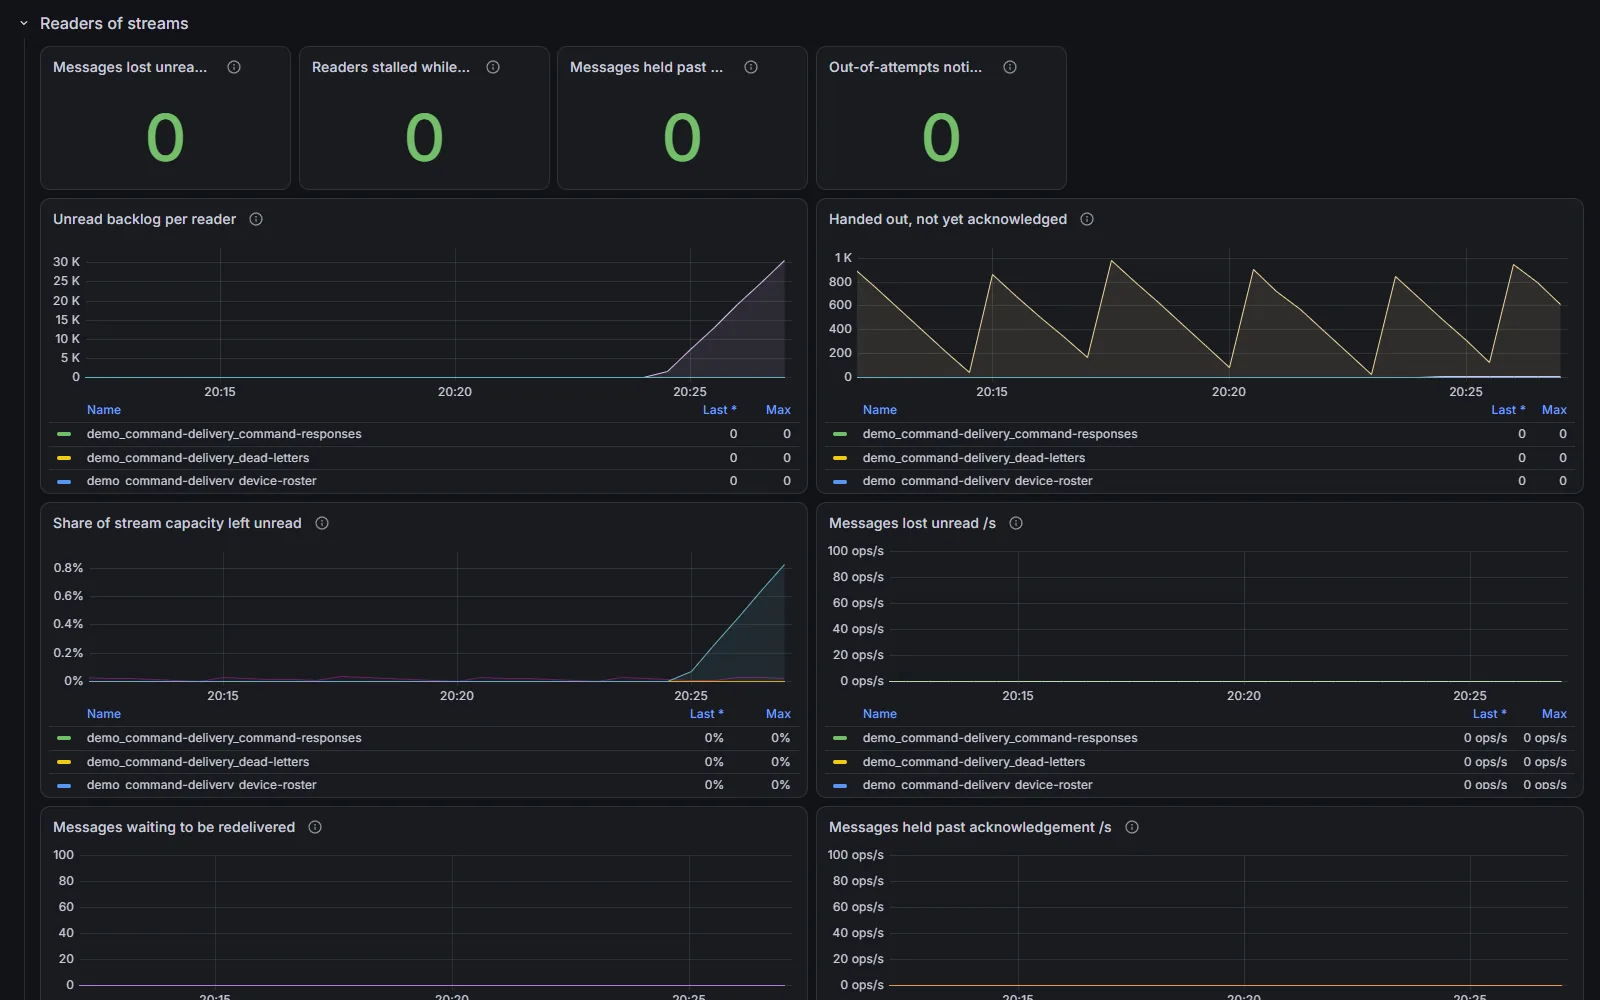
同一次中断期间的 Messaging,位于 Readers of streams。Unread backlog per reader 中停止的读取方的曲线上升(图例列出所有读取方;将鼠标悬停在曲线上可看到其名称),Share of stream capacity left unread 显示这部分积压占用了流限制的多少:此处不到 1%,离限制很远。
序列缺失表示“未测量”,绝不表示“没有等待的消息”。如果积压面板为空,说明两个来源都没有上报:请检查代理是否被采集(Messaging 的 Broker servers up),以及读取方的 durable 是否存在。
总览
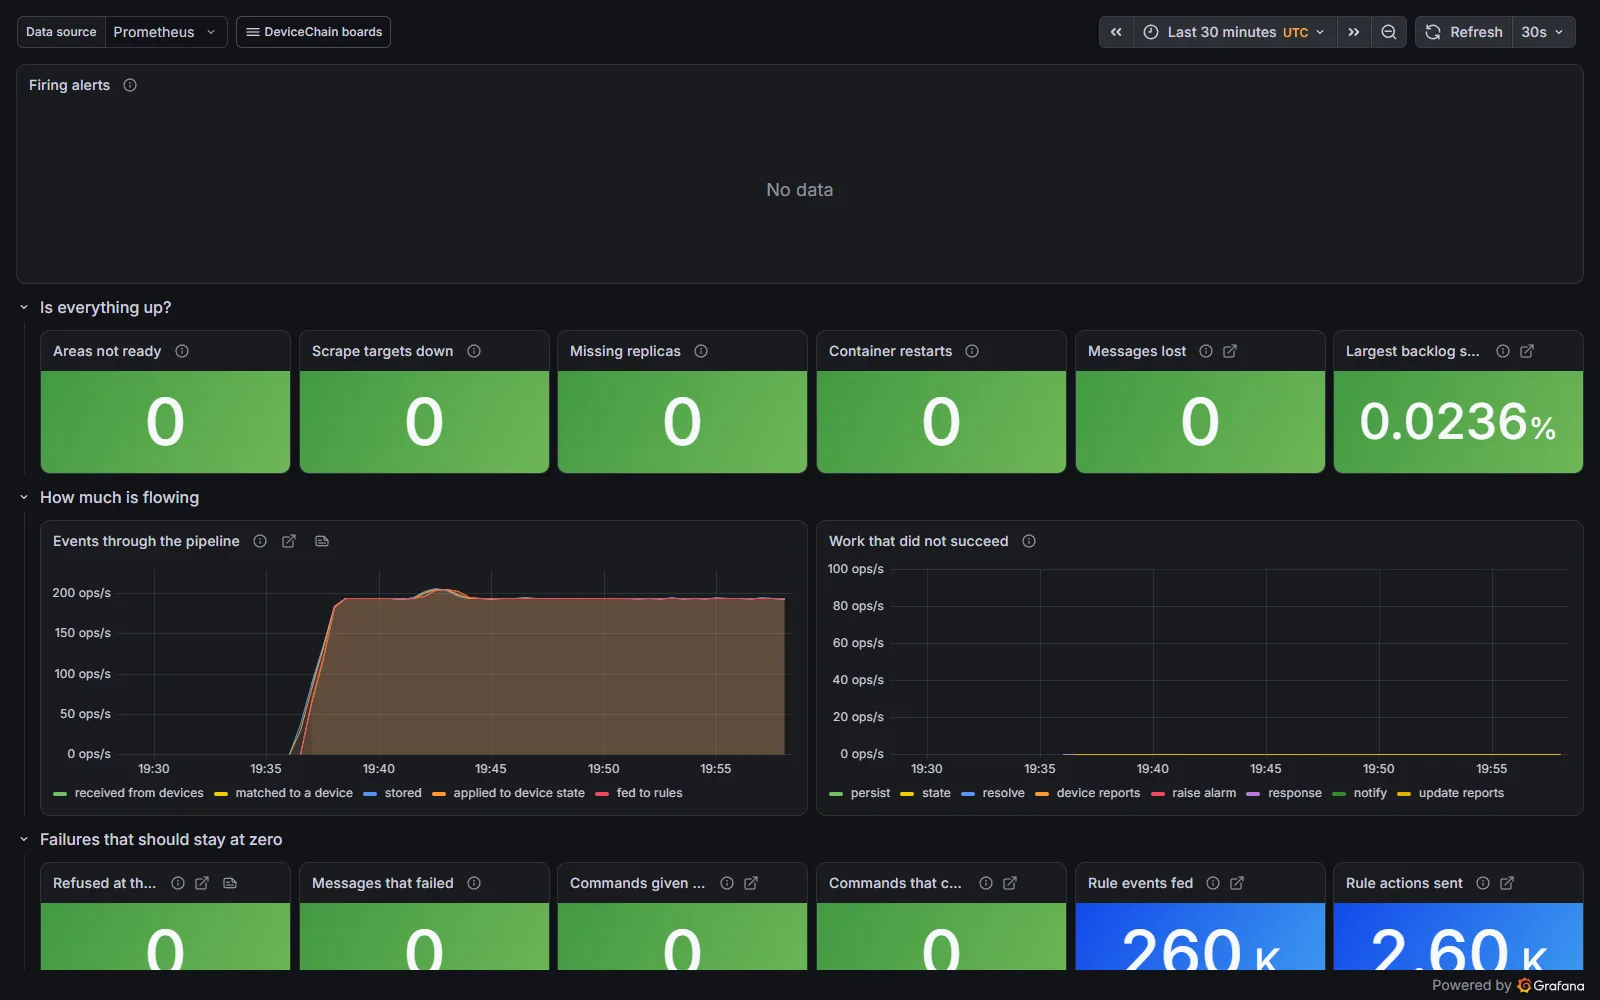
稳定负载下的总览。Is everything up? 下的每张指标卡都是绿色,Events through the pipeline 中的曲线相互重合:接收、匹配到设备、存储、应用到设备状态以及送入规则的事件都以相同速率推进。哪个阶段的曲线脱离了其他曲线,就打开哪个阶段的仪表盘。
**用它一眼回答“一切都在运行吗?有没有东西在丢失?”**从这里开始,再沿链接进入不是绿色的那个阶段的仪表盘。
| 分组 | 显示内容 |
|---|---|
| Is everything up? | 未就绪领域、抓取目标宕机、缺失副本、容器重启、丢失消息,以及所有读取方中最大的积压占比。 |
| How much is flowing | 各阶段流经流水线的事件,以及未成功的工作,并排显示,便于对照着读。 |
| Failures that should stay at zero | 在入口被拒绝的消息、失败的消息、被放弃或无法投递的指令,以及注入的规则事件与发出的规则动作。任何非零指标卡都值得查看。 |
| Replicas and restarts | 各 deployment 的可用副本、各 Pod 的容器重启,以及下文介绍的两张领域指标卡。 |
| Stage boards | 指向七个阶段仪表盘的链接。 |
支撑它的告警:全部告警。对这个仪表盘最重要的是 InstanceAreaUnavailable 和 InstanceContainerRestarted。
宕机的领域与缩容到 0 的领域
某个领域的 Pod 全部消失后,它不再上报任何自己的内容:就绪状态、指标、抓取目标都没有了。此时 Areas not ready 和 Scrape targets down 指标卡可能显示零,而该领域根本没有运行,因为缺失的序列不等于零。另有两张指标卡改为读取 Kubernetes 的 deployment,它们始终记录期望什么、实际有什么:
| 指标卡 | 统计 | 颜色 | 告警 |
|---|---|---|---|
| Areas with no pod available | 期望至少一个 Pod 却没有任何可用 Pod 的领域和控制台。 | 从 1 起为红色。 | InstanceAreaUnavailable,十分钟后触发。 |
| Areas scaled to 0 | 被设置为运行零个 Pod 的领域和控制台。 | 从 1 起为蓝色。 | 无。 |
区别在于意图。降为零的领域是被手动缩容的(kubectl scale … --replicas=0),例如因维护而暂停,所以它作为独立状态显示,而不是故障,也绝不会告警。两张指标卡不会重复统计同一个领域。如果某个领域出现在 Areas scaled to 0 中而你并没有缩容它,请把它扩回去:它没有在提供服务,而且不会有任何告警通知你。这两张指标卡统计的是各领域和控制台(它同样是实例的一个 deployment);消息代理的调试 Pod 不属于领域,因此被排除在两张指标卡和告警之外。
实例的配置档不运行的领域根本没有 deployment,因此两张指标卡里都不会出现。
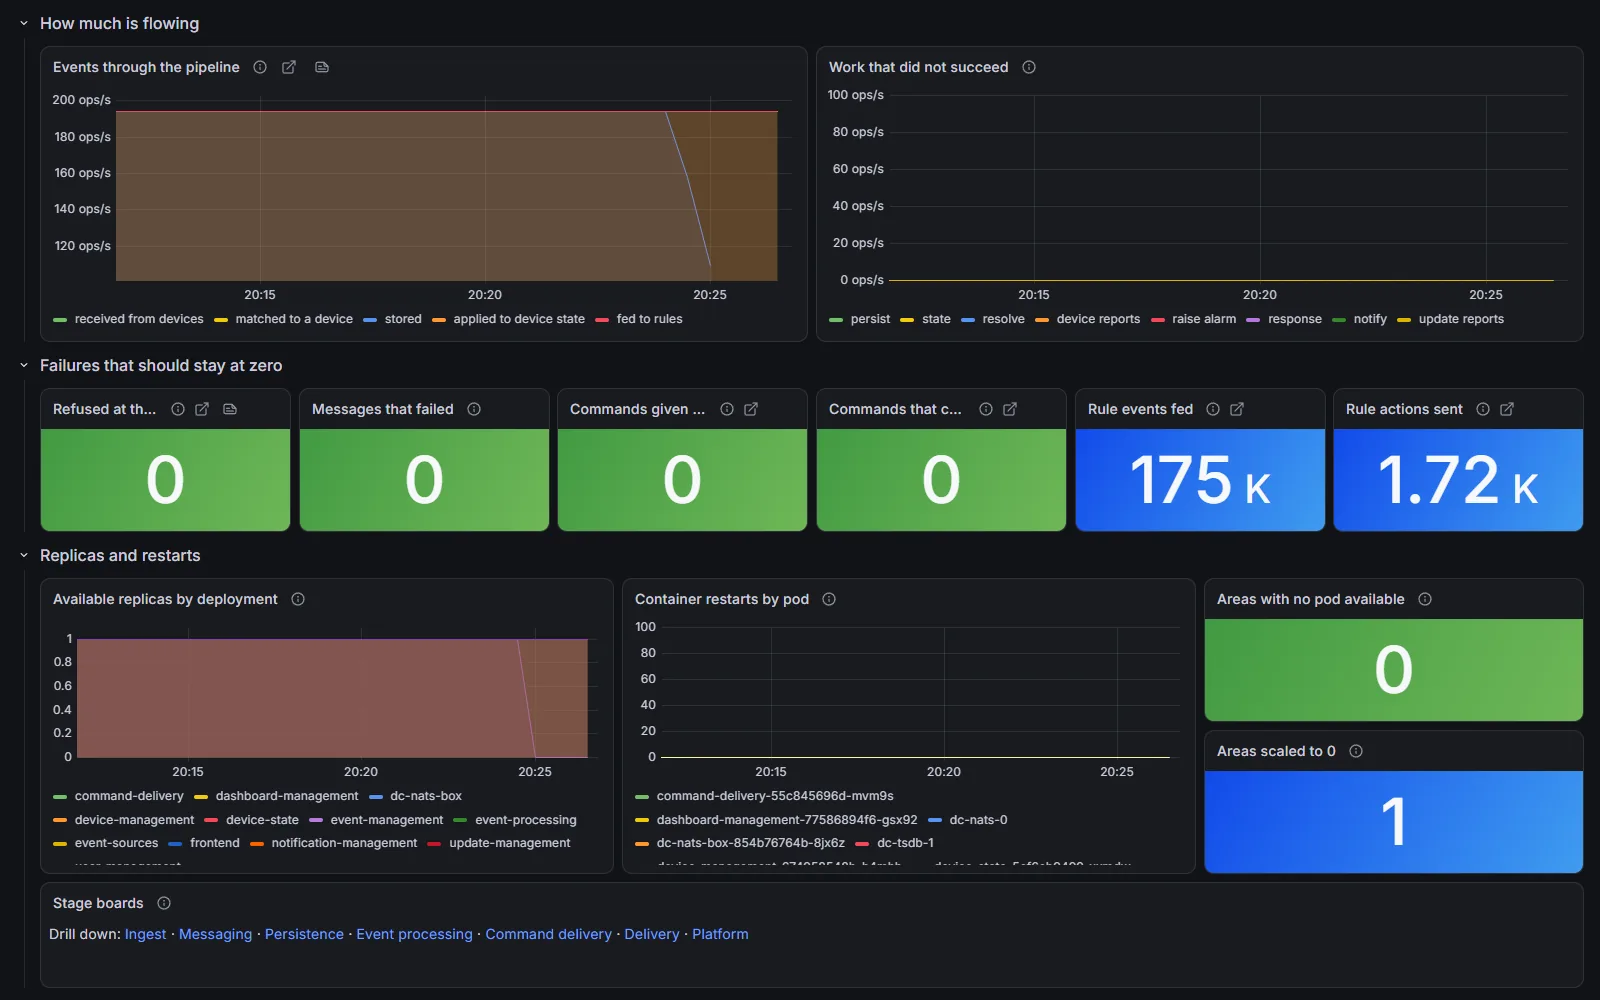
event-management 缩容到 0 时的总览。在 Events through the pipeline 中,存储曲线下降,而之前的各阶段保持原有速率。Areas scaled to 0 以蓝色显示 1,Areas with no pod available 保持为 0,因为该领域是被有意停止的。
Ingest
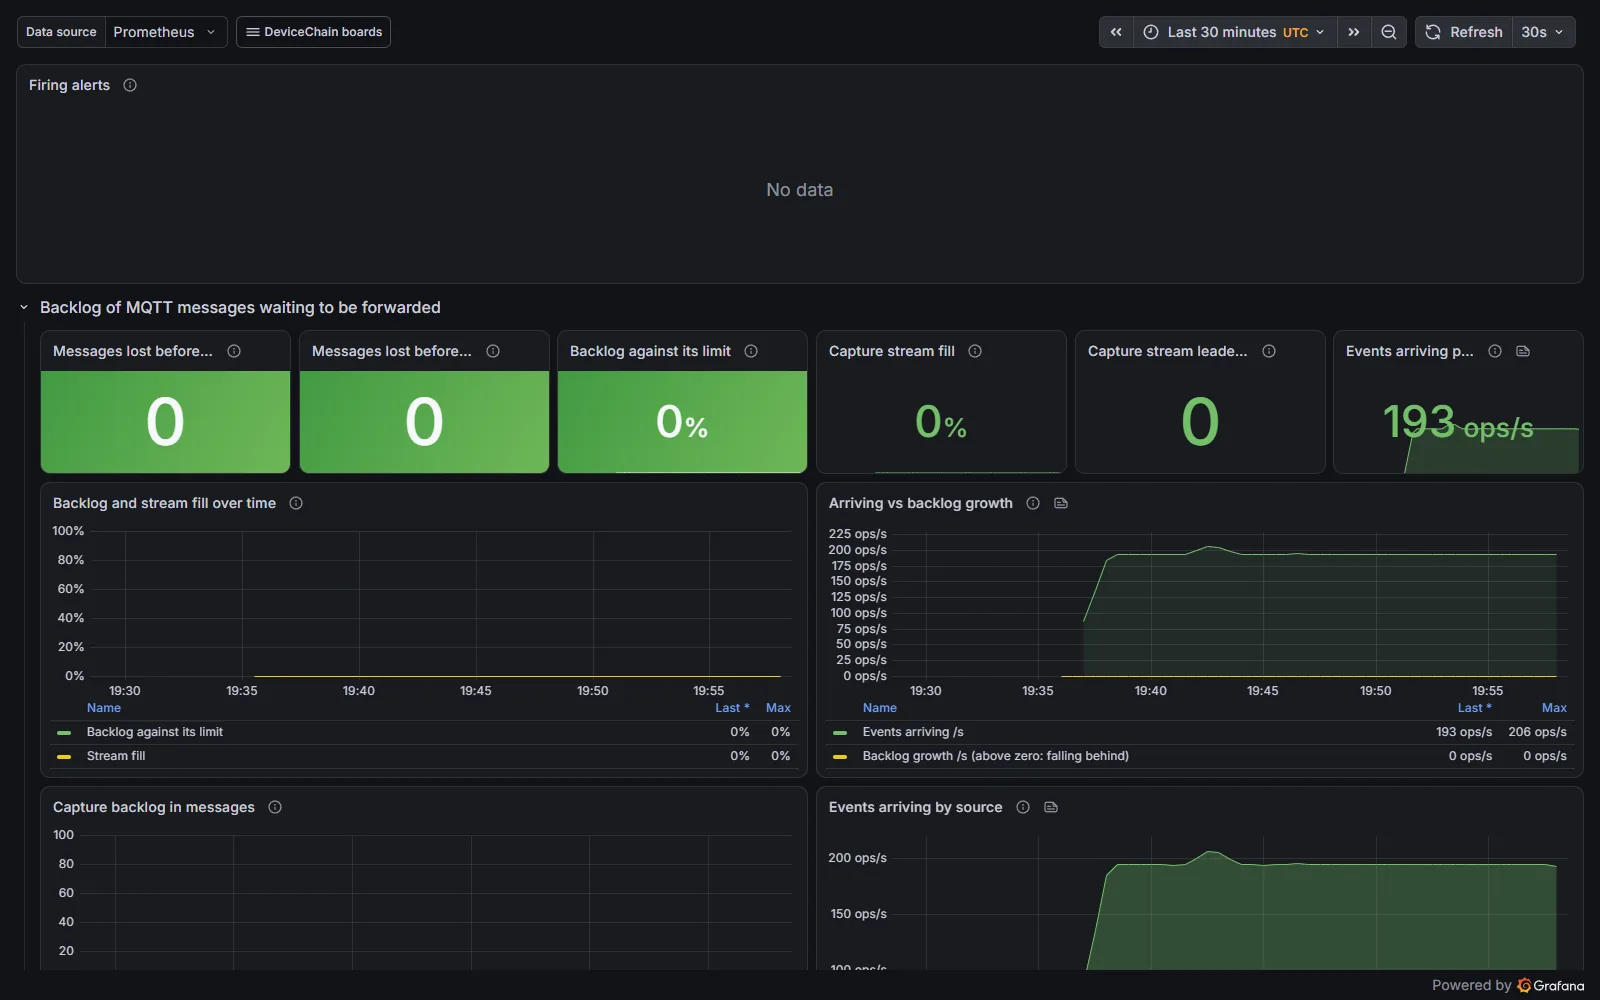
相同负载下的 Ingest。事件以稳定速率到达,Arriving vs backlog growth 中的积压增长曲线保持为零,说明实例跟得上;高于零则表示事件到达的速度快于转发的速度。这里的设备通过 HTTP 发送,因此 MQTT 捕获流保持为空。
**事件没有到达、被拒绝,或 MQTT 路径承压时使用。**它覆盖前门:传输层接受什么、拒绝什么,以及尚未完成转发的 MQTT 消息积压(等待中或处理中)。
| 分组 | 显示内容 |
|---|---|
| Backlog of MQTT messages waiting to be forwarded | 捕获流的积压相对其上限的比例、占用率、读取前丢失的消息和 leader 变更。积压面板带有代理回退(Capture backlog in messages 的未读缺口线除外)。超过 10% 且仍在上升时,增加 event-sources 副本;达到 100% 时最旧的未读消息会被丢弃。 |
| Refused or lost at the door | 为保护未读数据而被拒绝、被速率限制拦下、因格式错误被拒绝、因租户已删除或 MQTT 正文中含凭据被拒绝的消息,以及失败的外部发布。 |
| Protection of the MQTT message store | 必需消费者是否在位、被恢复的存储设置、没有大小上限的网关流,以及因存储已满或繁忙而被拒绝的连接。 |
| Device presence and external sources | 未记录的上线与下线变化、读取方不是恰好一个的外部 MQTT 来源,以及设备登录缓存。 |
| Device self-registration | 已注册设备、按原因划分的拒绝,以及响应时间。 |
| Sparkplug ingest, LwM2M ingest | 仅在这些可选服务运行时出现:活跃读取方或服务状态、失败,以及各协议的流量。两者各有完整的仪表盘:Sparkplug ingest 和 LwM2M ingest。 |
支撑它的告警:接入链路背压和消费者从未读取的消息中介绍的 MQTT 与捕获流告警,无人读取的外部 MQTT 来源中的外部来源告警,设备自注册中的注册告警,以及凭据缓存和速率限制器告警,还有 Sparkplug 与 LwM2M 接入告警。
Messaging
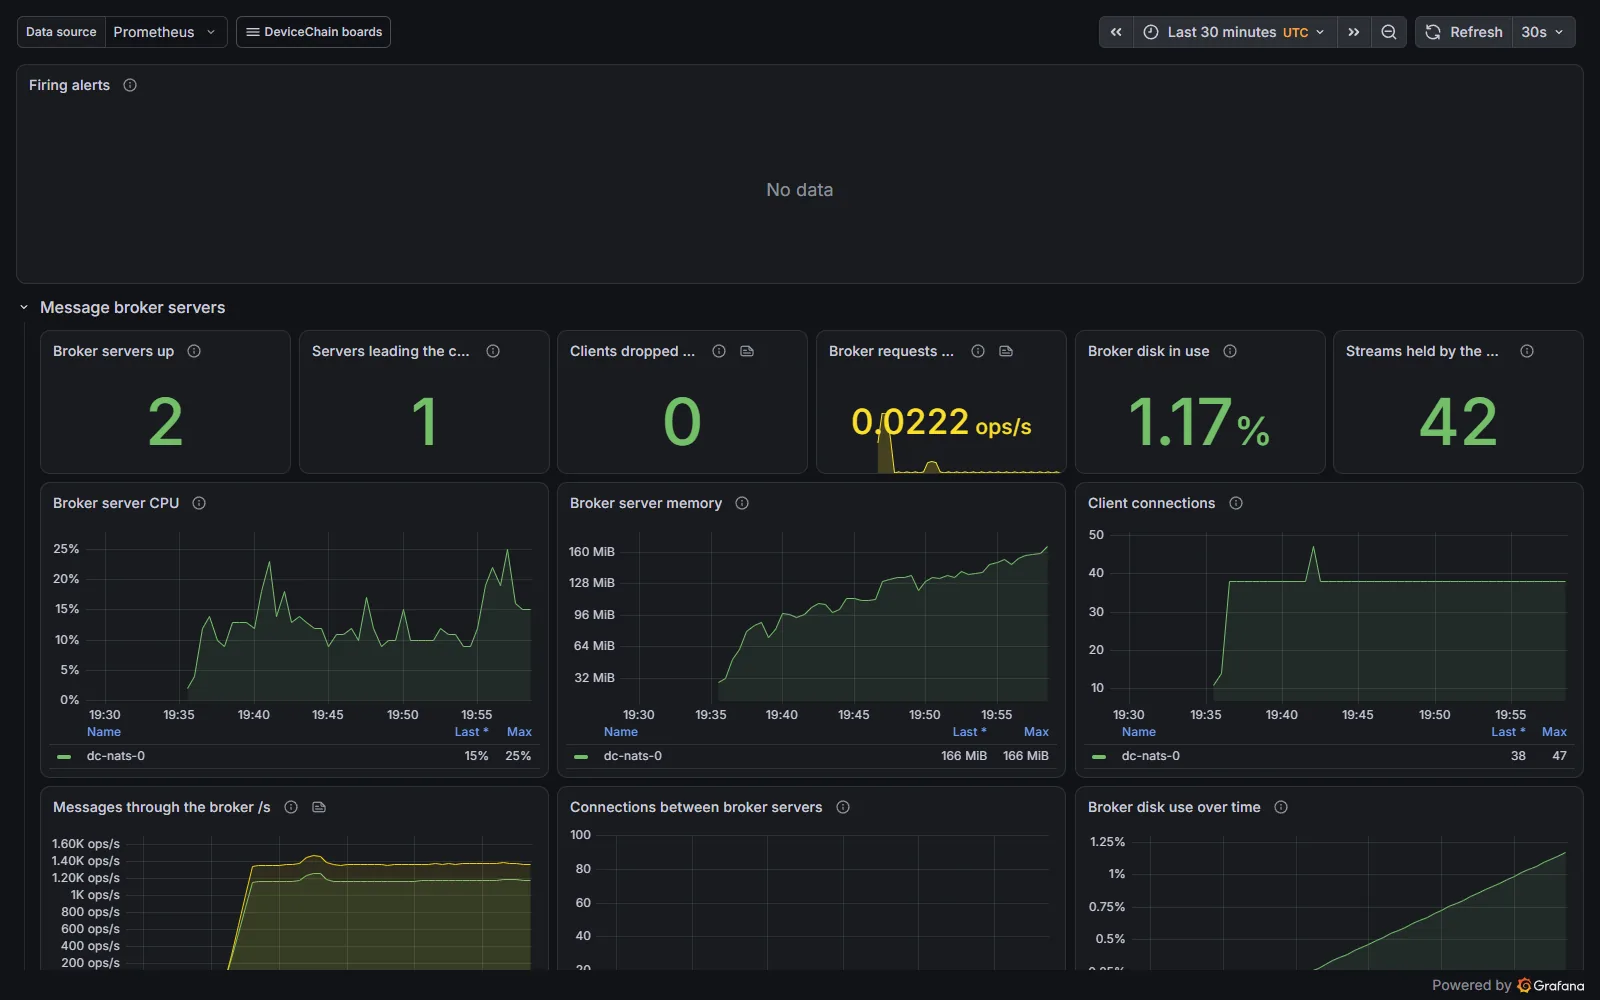
相同负载下的 Messaging:代理服务器、它们的 CPU、内存和客户端连接,以及经过它们的消息。当某处出现积压而你不知道在哪里时,下方的 Readers of streams 分组会指出是哪个读取方。
**某处变慢或积压、但你还不知道在哪里时使用。**消息代理连接所有阶段,所以这个仪表盘展示共享的底层设施:代理服务器、它们保存的流、谁在读取以及落后多少,以及各副本是否同步。
| 分组 | 显示内容 |
|---|---|
| Message broker servers | 在线服务器、集群 leader、因过慢被断开的客户端、请求失败、磁盘、CPU、内存和连接。 |
| Streams | 占用超过 80% 的流、拒绝新事件的流、按大小和按消息数的占用率,以及磁盘上最大的流。 |
| Readers of streams | 每个读取方的未读积压、已交付未确认的消息、流容量中未读的占比、读取前丢失的消息,以及超过确认窗口的消息。积压回退适用于前三项。 |
| Publishing and backpressure | 被背压拒绝的事件、发布耗时,以及发布方等待代理的时间占比。 |
| Copies and leaders | 副本数少于配置或副本已过期的流、流 leader 变更,以及哪些服务器担任过 MQTT 网关存储的 leader。 |
| Failed deliveries and dead letters | 耗尽投递次数的消息、已保存、未保存或丢失的死信,以及静默失效的代理连接。 |
| Key-value buckets and caches | 由内存应答的缓存读取、已用内存、被逐出的条目、失败和操作耗时。 |
支撑它的告警:JetStream* 告警、BrokerConnectionDiedSilently、ReaderHeldMessagePastAckWait、MaxDeliveryRecordsWaiting、ReplayCoveredDeliveriesExhausted、BrokerPresenceLosingTransitions、复制告警和死信告警。
Persistence and state
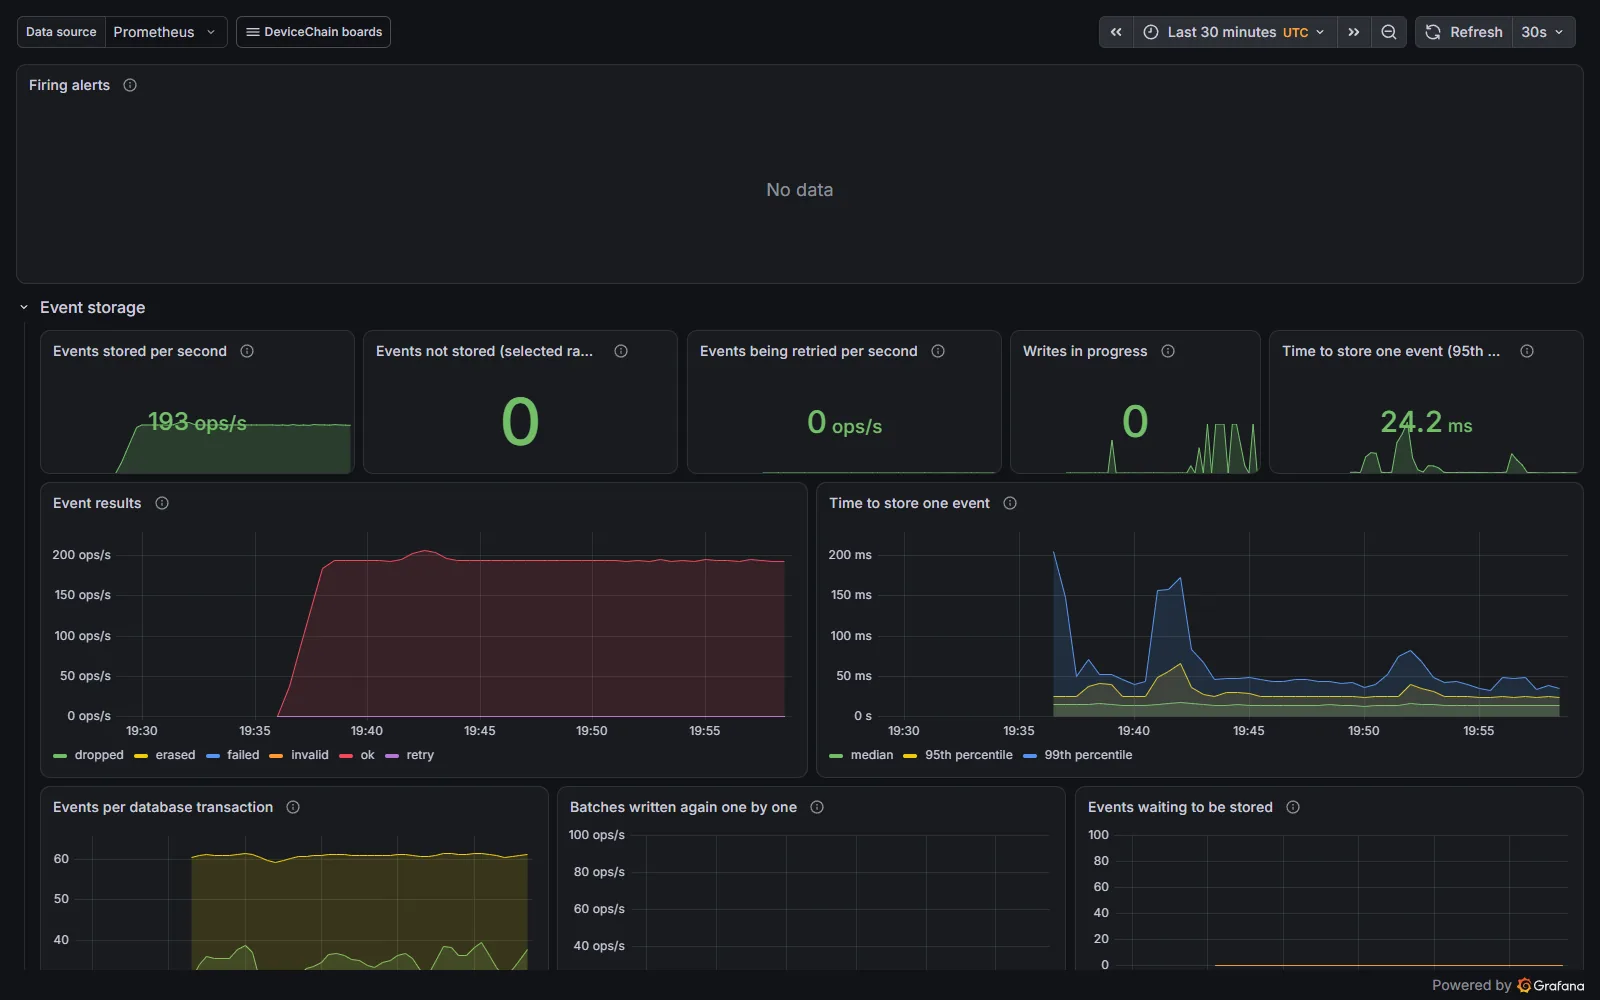
相同负载下的 Persistence。Events stored per second 与 Ingest 上的到达速率一致,Events not stored 为 0,存储一个事件的第 95 百分位耗时在几十毫秒,Events waiting to be stored(右下)平贴在零。
**事件已被接受却没有出现,或设备实时状态过期时使用。**它跟随事件进入事件存储和设备实时状态,然后检查下面的数据库。
| 分组 | 显示内容 |
|---|---|
| Event storage | 每秒存储的事件、未存储的事件、重试、进行中的写入、存储一个事件的耗时、每个事务的事件数,以及等待存储的事件(带有积压回退)。 |
| Live device state | 设备状态投影的同一组指标:每秒更新、丢失、重试、每次更新耗时,以及等待应用的更新(带有回退)。 |
| Background jobs in the event store | 距上次历史修复的时间、计算指标重建,以及汇总刷新的耗时与冲突。 |
| Databases | 服务器与集群状态、正在流复制的备库、连接、最长的未结束事务、提交与回滚、大小、备库延迟,以及哪个 Pod 是主库。 |
| Write-ahead log and backups | 等待发送的日志段、发送失败、距上次发送日志段的时间,以及最新基础备份的年龄。 |
| Disk space | 最满的数据库磁盘和备份磁盘、事件存储磁盘写满前的最短时间,以及最大的历史表。 |
| Tenant removal | 进行中的删除、最久未结束的删除、完成与失败,以及拖住删除的存储。 |
关系型数据库和备份对象存储位于集群内所有实例共享的命名空间中。这些面板在说明里写明了这一点,显示的是共享数据库,而不只是本实例的。
支撑它的告警:DeviceStateDroppingEvents、备份归档和数据库控制平面告警、Database* 卷告警、BackupDestination*,以及 TenantPurge*。
Event processing
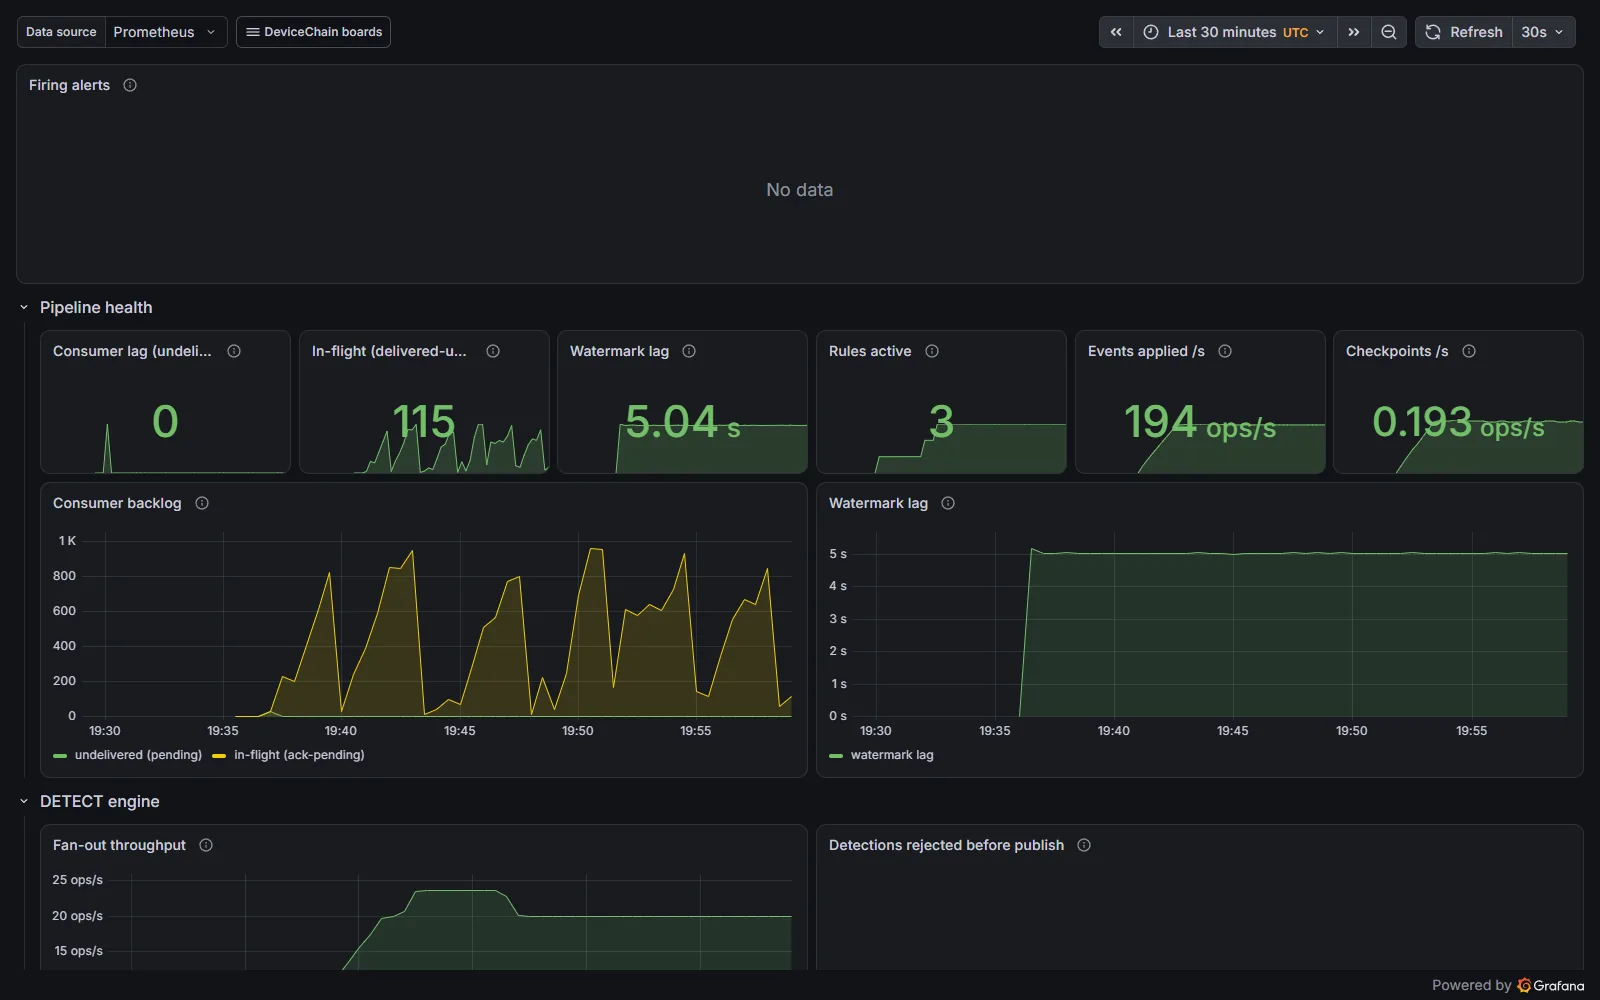
规则触发和清除告警并发送命令时的 Event processing。Consumer lag 为 0;In-flight 随批次的分发和确认而起伏,这在负载下是正常的。Watermark lag 保持平稳;持续上升的曲线表示检测正在落后于时钟。
**规则不触发、告警延迟,或反应没有被执行时使用。**它监控事件处理中介绍的检测与反应引擎。
| 分组 | 显示内容 |
|---|---|
| Pipeline health | 消费滞后、在途消息、水位线滞后、生效的规则、每秒应用的事件和每秒检查点。消费滞后、在途消息和消费者积压面板带有积压回退。 |
| DETECT engine | 扇出吞吐量、发布前被拒绝的检测结果、求值错误,以及版本丢弃安全闸。 |
| REACT dispatcher | 已分发的动作、分发故障、派生事件积压(带有回退)、并发度和分发延迟(p50 与 p99)。 |
| State budget | 存活的按键状态条目,以及超出规则、存活键或保留样本预算的租户。 |
| Snapshot and restore | 检查点开销、快照大小和启动时的恢复开销。 |
| JetStream streams | 流的占用率,以及消费者未读部分占流容量的比例。 |
| Geofence archive | 未解析或不一致的围栏几何,以及几何缓存的命中率、占用和逐出。 |
| Rule health and derived publish | 被丢弃的规则健康更新、积压与写入延迟,以及发布派生事件所占的时间比例。 |
支撑它的告警:Detect* 和 React* 告警、GeoFenceSetPublishFailing 和 DeviceFactPublishFailing。引擎的消费者如何运行与扩缩容,参见运行检测引擎。
Command delivery
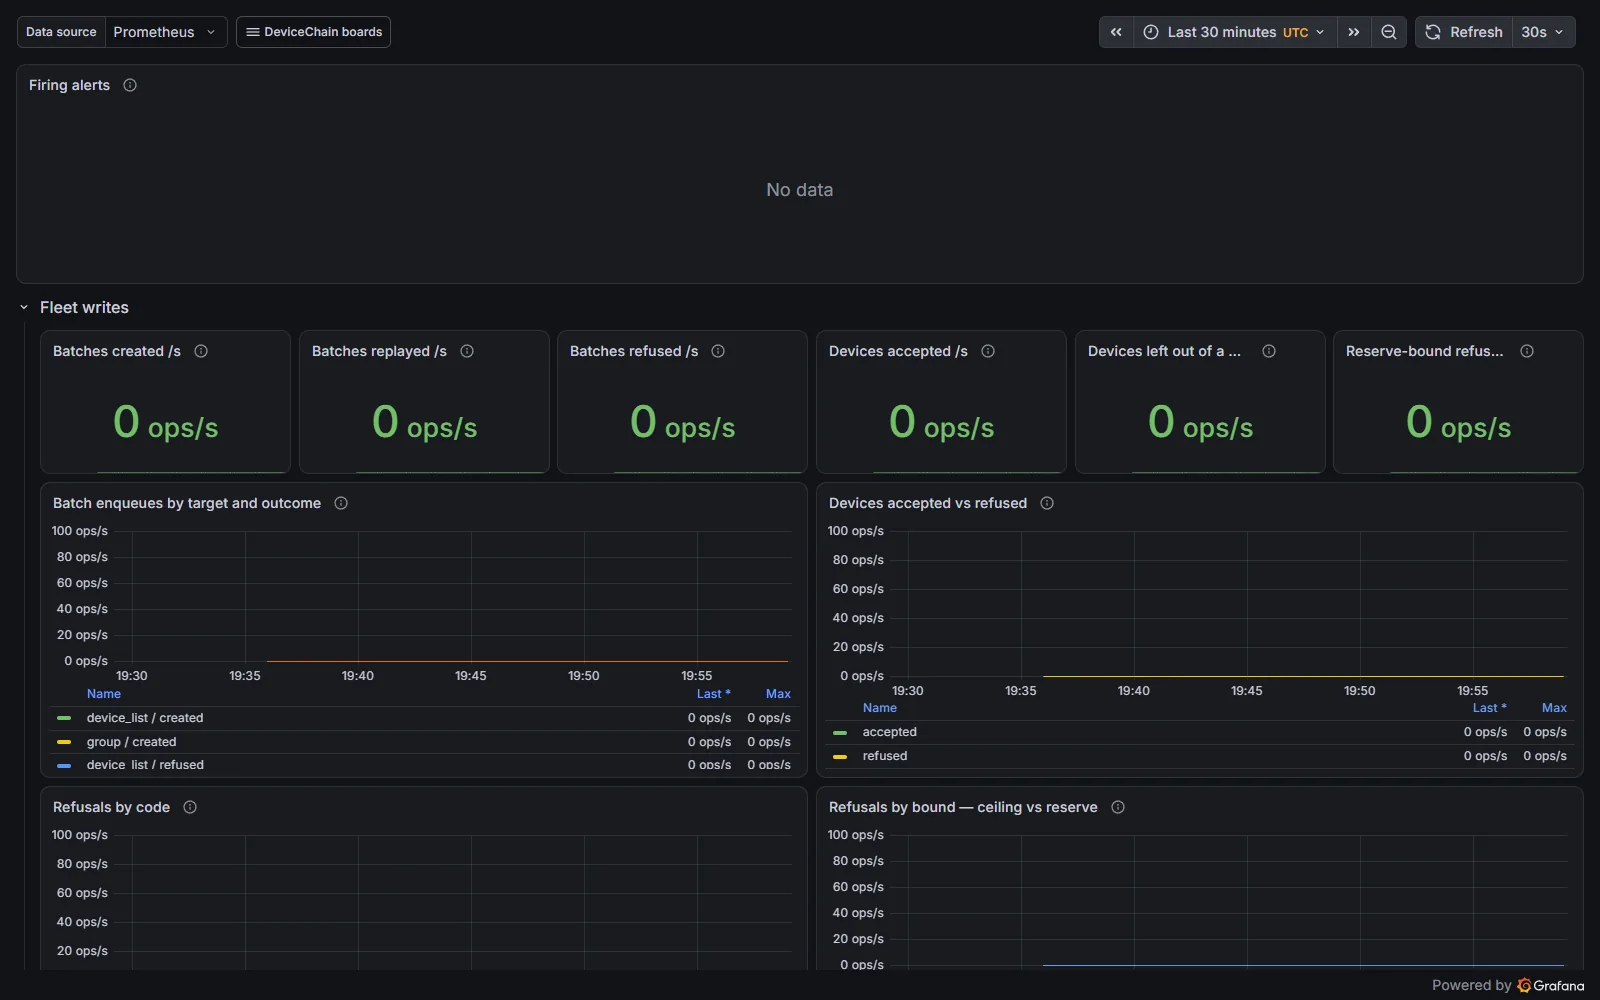
规则发送命令、设备应答时的 Command delivery。这段时间内没有任何一次以批量方式写入设备群,因此所有批量写入指标卡都为 0,拒绝图表保持平坦。规则发送的命令走分发路径;总览上的 Commands given up 和 Commands that cannot be delivered 指标卡对它们显示 0。
指令没有到达设备,或批量写入被拒绝时使用。
| 分组 | 显示内容 |
|---|---|
| Fleet writes | 每秒创建、重放和被拒绝的批次、已接受的设备、被部分批次排除的设备,以及按错误码和按限制(上限或预留)划分的拒绝。 |
| Dispatch | 滞留的认领、丢失的认领和无法投递的指令。 |
| Holds | 已设置与已释放的保持,以及在线状态读取错误。 |
支撑它的告警:所有 Command* 告警,详见指令投递。
Delivery
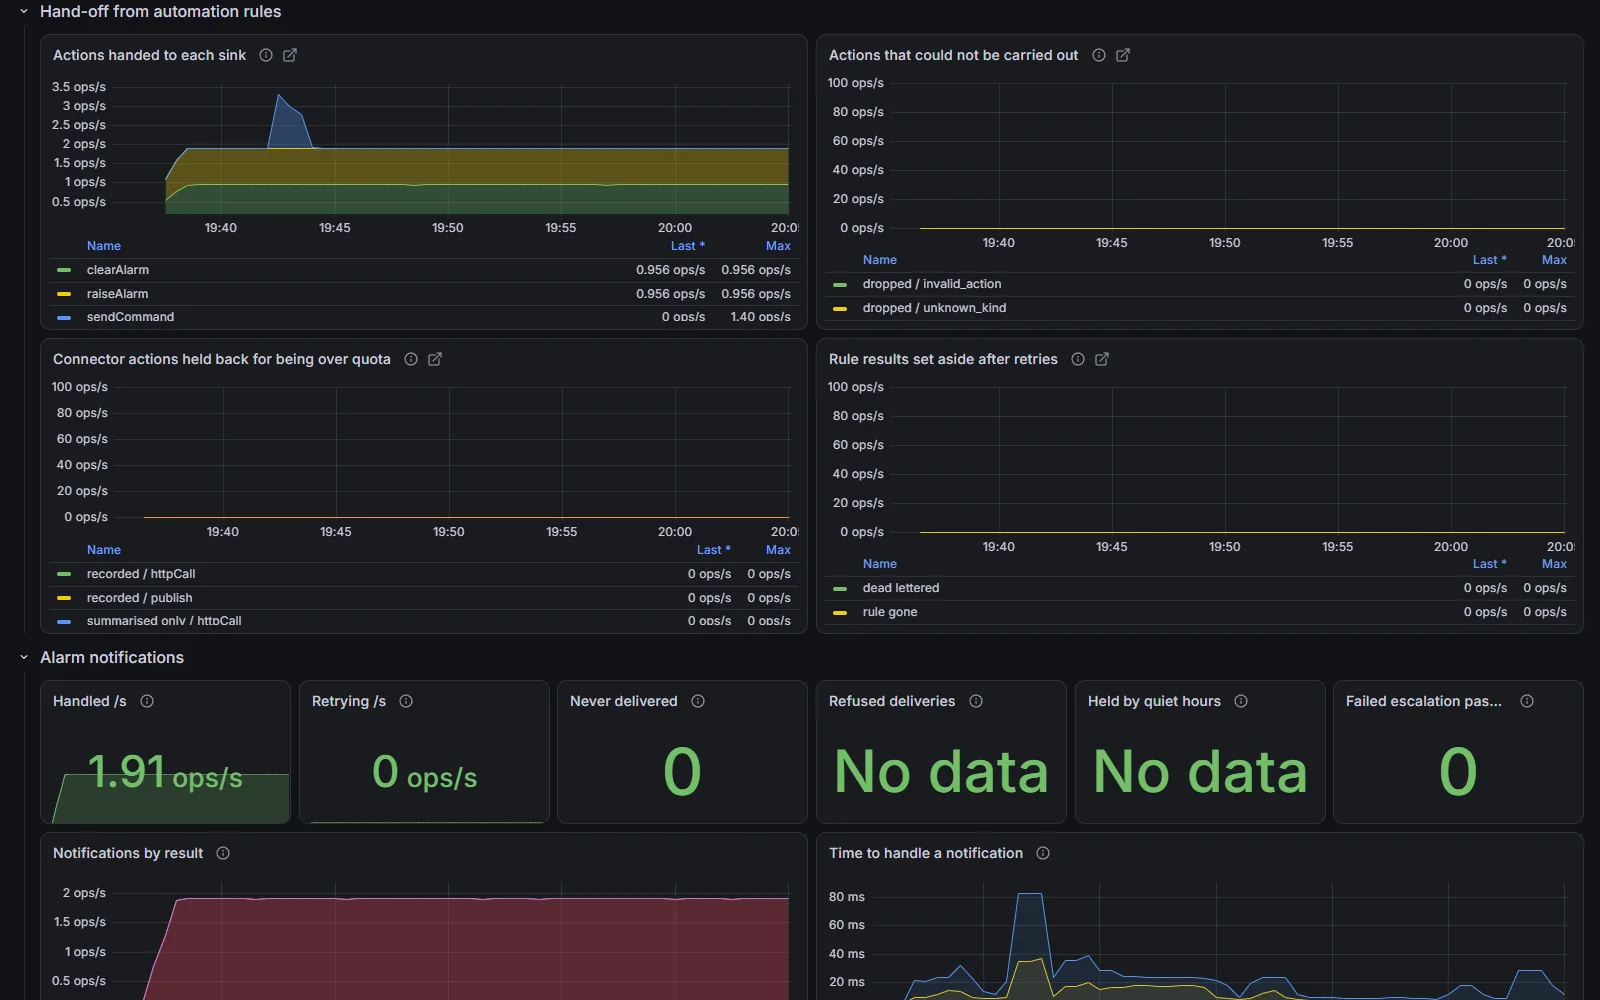
Delivery,从 Hand-off from automation rules 打开。规则把触发告警、清除告警和发送命令动作交给各自的接收端,没有动作被拒绝,随后的告警通知处理过程中没有重试。仪表盘的第一个分组(出站连接器)属于本实例未运行的可选服务,因此不显示数据。
**告警已经发生但没有人收到通知,或连接器、更新卡住时使用。**这是最后一程,从规则的反应到某个人或外部系统。连接器和软件更新分组属于可选服务:实例不运行某个服务时,对应分组仍留在仪表盘上,并显示 No data。
| 分组 | 显示内容 |
|---|---|
| Outbound connectors | 已发送、重试中、已放弃、被阻止的目的地和丢失的分发,按结果、连接器类型和失败原因划分,另有分发积压。 |
| Hand-off from automation rules | 交给各出口的动作、无法执行的动作、因超出配额而暂缓的动作,以及重试后被搁置的规则结果。 |
| Alarm notifications | 已处理、重试中和从未送达的通知、拒绝、免打扰时段的暂缓、升级轮次、处理耗时和通知积压。 |
| Software updates | 按结论划分的设备上报、按结果划分的下载与授权、发布进度、失去响应的更新尝试,以及更新上报积压。 |
四个积压面板都使用代理回退。
支撑它的告警:ConnectorDispatchRateLimited、ReactConnectorEgressShedding 和 ReactShedLettersOverBudget。通知分组没有专属告警,请在这个仪表盘上查看。软件更新分组有四条:UpdateDownloadsNotConfigured、UpdateReportsMostlyRefused、UpdateRolloutStepsFailing 和 UpdateAttemptsGoingUnknown。
Platform
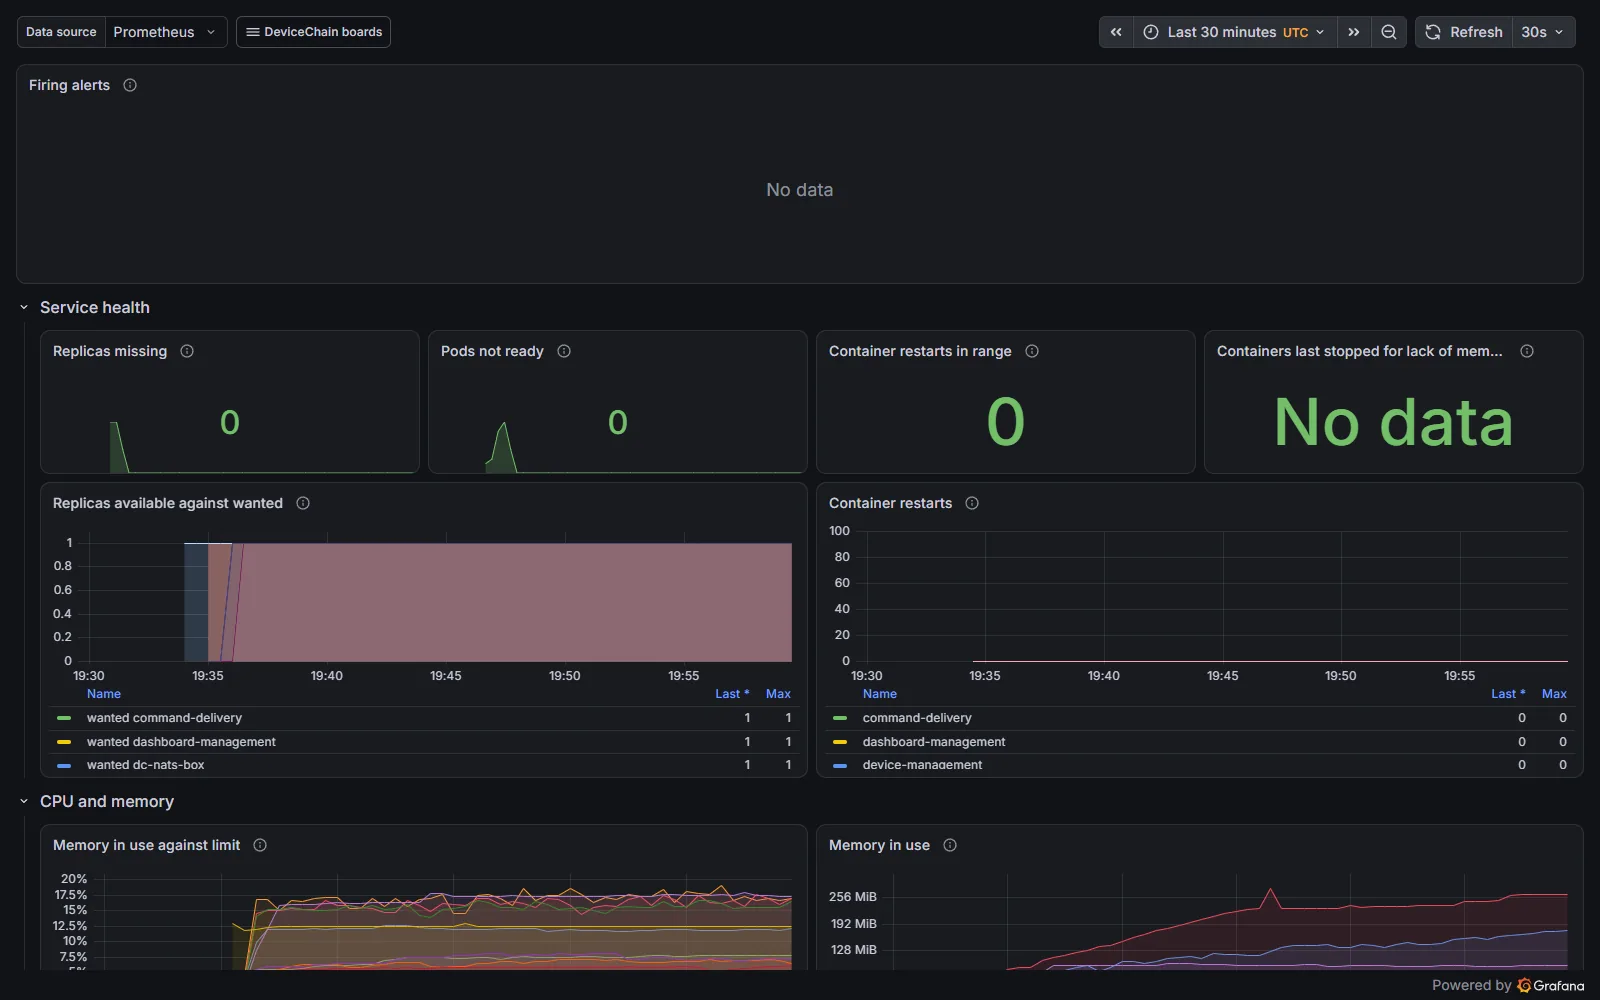
相同负载下的 Platform:没有缺失的副本,没有未就绪的 Pod,没有重启,每个 deployment 的可用副本数都等于期望值。底部的 Memory in use against limit 是调整服务限制之前应该查看的面板。
**某个服务看起来不健康、需要判断是服务本身还是其下的节点有问题时使用。**这是唯一一个关注进程而非消息流的仪表盘。
| 分组 | 显示内容 |
|---|---|
| Service health | 缺失副本、未就绪 Pod、容器重启、上次因内存不足而停止的容器,以及可用副本与期望副本的对比。 |
| CPU and memory | 内存相对限制、CPU 相对请求,以及 CPU 限流。 |
| Service runtime | Goroutine、堆、常驻内存、垃圾回收次数与停顿,以及已打开文件句柄相对上限。 |
| Sign-in | 按结果划分的凭据检查、被限流的登录、单点登录拒绝、身份提供商获取失败和令牌密钥获取。 |
| Tenant deletion | 与 Persistence 相同的删除视图,从平台侧查看。 |
| Limits and safety gates | 被关闭的安全闸、按平台默认值计量的租户、已用的共享额度、被舍弃的出站动作,以及设备流量和出站调用触及的上限。 |
| AI inference | 按结果划分的推理调用和使用的模型令牌。 |
支撑它的告警:InstanceContainerRestarted、Sso* 和凭据存储告警、TenantPurge*、SafetyGateDisabled 和 TenantsMeteredAtPlatformDefault、RateLimiterOverflowInUse、RateMeteringClockFallback、ReactShedLettersOverBudget 和 ConnectorDispatchRateLimited。
Sparkplug ingest
**Sparkplug 节点不再上报,或 Sparkplug 主机没有在读取时,使用它。**它沿着一条传输链路,从与代理的连接一路跟到已存储的读数,再到发回边缘节点的命令。该服务是可选的:未运行它的实例上,所有面板都显示“无数据”或零。
| 分组 | 显示内容 |
|---|---|
| Is it reading? | 活跃读取方(恰好一个才健康)、代理连接失败、被拒绝的分组订阅、被丢弃的消息、无法解码的消息,以及无法注册的节点。 |
| What arrives | 按类型划分的消息,以及它们产生的读数、在线状态变化和已注册设备。 |
| What was not stored | 按原因划分的被跳过读数,以及所有被丢弃的内容:接入时丢弃、无法解码、来自未知设备、属于正在删除的租户、过旧,以及超出租户上限而被限流。 |
| Presence and rebirths | rebirth 请求及被丢弃的请求、存活探测及其标记为离线的设备、注册恢复,以及一次探测需要多久、最近一次成功是什么时候。 |
| Commands to edge nodes | 等待结果的命令、未确认命令、命令故障、熔断器触发次数和熔断器未闭合的来源、按结果划分的命令、确认耗时,以及每个来源的熔断器状态。 |
支撑它的告警:运行边缘服务中的 SparkplugIngest* 和 SparkplugCommand* 告警。
LwM2M ingest
**LwM2M 设备无法访问、不再上报,或命令没有送达时使用。**它覆盖 CoAP 与 DTLS 服务器、它所持有的设备群、它存储的读数,以及通向设备的命令路径。该服务是可选的:未运行它的实例上,所有面板都显示“无数据”或零。
| 分组 | 显示内容 |
|---|---|
| Is it serving? | 主实例与正在服务的副本(各恰好一个)、被丢弃的通知、未执行的命令、被拒绝的握手,以及因达到上限被拒绝的会话。 |
| The fleet it holds | 注册、会话与观察、注册生命周期、故障切换标记、被拒绝的注册、DTLS 握手,以及健康探测请求。 |
| Readings | 通知与已存储读数、未产生读数的通知、非数值记录、所有被丢弃的内容,以及由遥测创建的设备。 |
| Commands | 按操作划分的已分发命令、被暂存的命令及原因、发往离线或其他设备的命令、命令故障,以及积压的排空。 |
| Device information and housekeeping | 设备信息采集及其写入问题,以及清除已删除租户注册的清扫任务。 |
支撑它的告警:运行边缘服务中的 Lwm2mIngest* 告警。
Edge agent
边缘代理运行在你站点的硬件上,它的指标端点只监听该设备的回环地址。实例的 Prometheus 永远不会采集它,因此 chart 不为它安装仪表盘。这个仪表盘是一个文件,导入读取你自己的 Prometheus 的 Grafana 即可:edge-agent.json。
使用时,先把各代理的指标送进一个 Prometheus。指标端点只监听设备的回环地址(127.0.0.1,端口为 local.metricsPort,默认 9090),因此采集器必须是设备本机上的进程:设备之外的任何东西都无法访问它。每个代理的序列都必须带有唯一的 agent 标签。仪表盘的选择器、图例和分组都使用它;没有它,不同设备的序列标签完全相同,在接收端会互相覆盖。请在每台设备的采集器上把它设为外部标签。以 Prometheus 的 agent 模式为例:
global:
  external_labels:
    agent: site-berlin-01   # unique per box
scrape_configs:
  - job_name: dc-edge-agent
    static_configs:
      - targets: ["127.0.0.1:9090"]
remote_write:
  - url: https://prometheus.example.com/api/v1/write
看板的进程面板(内存、CPU、goroutine、打开的文件)选择作业 dc-edge-agent,请保留该 job_name:使用其他名称时这些面板为空。
代理的默认端口 9090 同时也是 Prometheus 的默认监听端口,所以要让其中一个换端口:像下面这样让采集器使用另一个端口,或在代理配置中设置 local.metricsPort 并抓取该端口。
prometheus --enable-feature=agent --config.file=agent.yml --web.listen-address=127.0.0.1:9091
然后在 Grafana 中选择 Dashboards, New, Import,上传该文件,并把那个 Prometheus 选为数据源。仪表盘有两个选择器:Agent(所有发送该标签的代理)和 Lookback(向前回溯多久来寻找已停止上报的代理)。失去链路的站点会停止发送一切,包括它自己的断开状态,因此 Known agents reporting、Agents silent 两个指标块和 Agents 表会把当前正在上报的代理与回溯窗口内见到过的代理做对比。仪表盘没有 Firing alerts 表,因为代理不附带告警规则。
| 分组 | 显示内容 |
|---|---|
| Is every site connected? | 正在上报的已知代理占比、静默的代理、已断开的代理、最旧的缓冲事件、最满的缓冲区、因溢出而丢失的事件、被拒绝的事件、本地端口开放的代理,以及每个代理一行的表格。 |
| Connectivity | 各代理随时间变化的云端链路,以及等待云端确认的发布。 |
| Store-and-forward backlog | 最旧缓冲事件的年龄、缓冲事件数、缓冲区用量与上限、缓冲区占用率,以及因溢出而丢失的事件。 |
| Throughput | 读取待转发的事件与云端已确认的事件、各代理的转发量,以及失败的转发尝试。 |
| Refused and rejected events | 按原因划分的拒绝、被保留或未匹配的被拒绝事件、在设备上被丢弃的事件,以及本地端口是否要求凭据。 |
| The agent process | 各代理的内存、CPU、goroutine 与打开的文件。 |
每个面板读取的都是代理导出的序列。代理源码树中的一项测试会把该文件与代理的真实指标核对,因此指标改名会让构建失败,而不是让某个站点留下一张空图。
仪表盘未覆盖的内容
- Kubernetes Operator 运行在它自己的命名空间中。没有任何组件采集它的指标,也没有仪表盘显示它,连副本面板也不显示,因为那些面板只读取本实例的命名空间。
- 每个服务的 HTTP 与 GraphQL 请求速率、错误和延迟没有导出,因此没有仪表盘绘制它们。
- 从接入到存储或检测的端到端事件年龄没有被测量。积压面板只是替代:积压增长就意味着延迟增长。最接近的真实年龄度量是
detect_watermark_lag_seconds,Event processing 将其显示为 Watermark lag,即检测引擎水位线落后墙上时钟多少。 - 边缘代理运行在客户硬件上,实例的 Prometheus 不会采集它,因此 chart 中没有任何仪表盘显示它。请把边缘代理仪表盘导入读取你自己的 Prometheus 的 Grafana。