Paneles de Grafana
La pila de monitoreo que despliega dcctl install
incluye diez paneles de Grafana por instancia: un resumen que responde a "¿está todo en
marcha?", siete paneles por etapa, uno por cada etapa que atraviesa un mensaje desde un
dispositivo hasta una notificación entregada, más la plataforma que los sostiene, y dos paneles
para los servicios opcionales Sparkplug y LwM2M. Cada panel es el punto de
partida para una pregunta, y cada uno enlaza con el siguiente que abriría. El agente de borde se
ejecuta fuera del clúster y tiene en su lugar su propio archivo de panel.
Todo lo que muestran los paneles se construye con las métricas que los servicios ya exportan (consulta la referencia de métricas) y con las series estándar de Kubernetes, de la base de datos y del broker de mensajes que recoge la pila de monitoreo. No hay que activar nada para tenerlas.
Las imágenes de esta página se tomaron en una instancia local de un solo nodo con una carga sintética constante de cuatro inquilinos: telemetría, alarmas que las reglas generan y resuelven, y comandos que los dispositivos responden. Las horas están en UTC; las imágenes de los paneles cubren 30 minutos y las de la interrupción, 15.
Dónde encontrar los paneles
Abra Grafana y busca la carpeta
devicechain-<instancia>. Cada instancia tiene su propia carpeta y su propia copia de cada panel,
con el título DeviceChain — <nombre> [<instancia>]. Un panel solo lee los datos de su propia
instancia: no hay selector de instancia, y los paneles de una instancia no pueden mostrar los de
otra.
Todos los paneles tienen en la parte superior un menú DeviceChain boards que lista los paneles de esta instancia, y el resumen termina con una fila de enlaces a los paneles por etapa. Lo único que se elige es el origen de datos, que es el Prometheus instalado por la pila.
Todos los paneles empiezan con la misma tabla Firing alerts. Lista las alertas que se están disparando ahora mismo para esta instancia y que pertenecen a la etapa del panel, de modo que un panel por etapa está en silencio cuando su etapa está bien. Una tabla vacía significa que no se dispara ninguna; Grafana la muestra como No data. La tabla lee las reglas de Prometheus de la instancia, así que sigue vacía si esas reglas no están instaladas. El resumen lista todas las alertas, por lo que una alerta que ningún panel por etapa recoge sigue siendo visible allí.
Cómo leer un panel
Cada panel tiene una descripción: pase el cursor sobre la pequeña i de su esquina. Indica qué
cuenta el panel, cómo es un valor normal y qué hacer ante uno anómalo. Las convenciones siguientes
valen para todos los paneles.
- Los indicadores se colorean según lo que significan. Verde es sano, amarillo significa "mira pronto" y rojo significa "actúa". Un indicador cuyo nombre dice "over the range" o "selected range" cuenta lo ocurrido en el intervalo de tiempo elegido, así que amplía el intervalo para mirar más atrás; uno sin esa indicación muestra el valor actual.
- Un indicador que debe mantenerse en cero muestra
0, no "No data". Cuando un recuento no tiene nada que contar, el panel sustituye cero a propósito. Un panel que muestra "No data" te está diciendo que la serie aún no se ha reportado, lo cual es distinto de que no haya pasado nada.
Paneles de retraso acumulado y qué muestran cuando un lector está caído
Estos paneles de retraso acumulado (backlog) cuentan los mensajes que esperan ser entregados a un lector más los ya entregados pero aún no confirmados. Un panel separado de pendientes o en vuelo cuenta solo la parte que indica su título. Es la señal de alerta temprana más útil de la plataforma, porque un lector más lento que sus productores se retrasa mucho antes de que algo falle. Consulta Un consumidor que se queda atrás para saber qué significa el retraso y cómo se mide.
Cada servicio lector reporta su propio retraso, pero un servicio detenido no puede reportar nada. Un lector que se cayó, se está reiniciando o se escaló a cero es justo cuando más se quiere el número, y un panel que se queda en blanco en ese momento no sirve. Por eso los paneles de retraso tienen dos fuentes, por orden:
- El reporte del propio lector, mientras el servicio lector está en marcha.
- El recuento del propio broker de mensajes para ese mismo lector, tomado de las métricas del broker, cuando el lector no está reportando.
Un panel que puede recurrir a esta alternativa lo dice en su descripción ("While the reading service is down this shows the message broker's own count"). Ambas fuentes cuentan los mismos mensajes, así que el panel mantiene una línea continua cuando una releva a la otra.
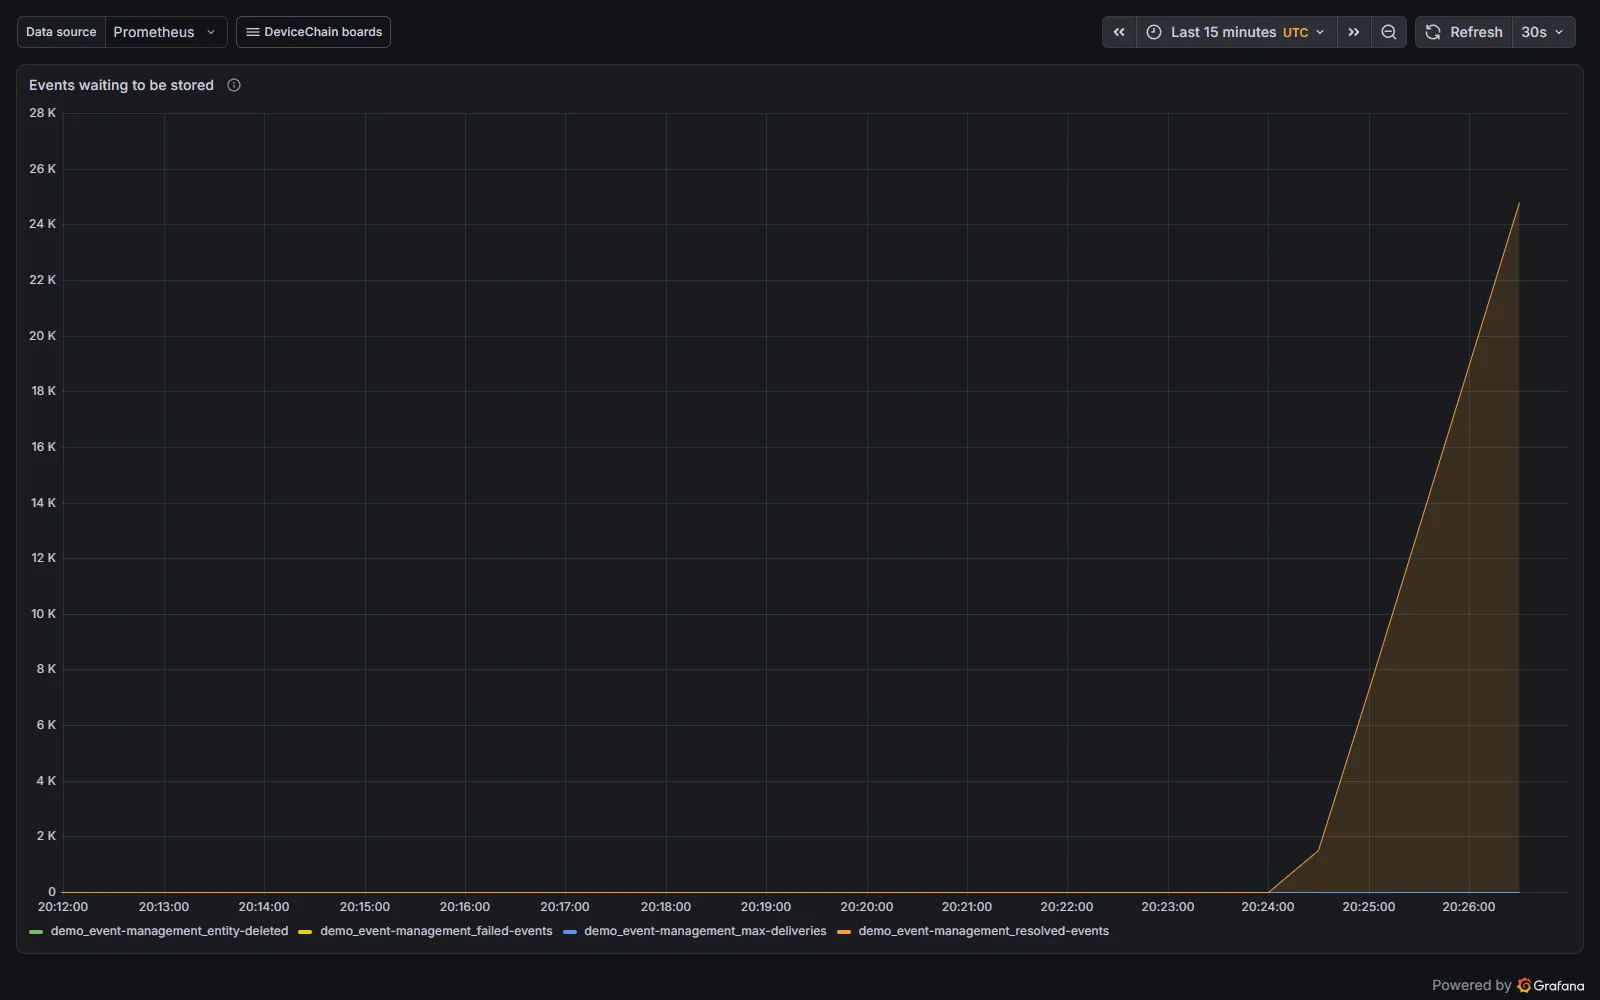
Events waiting to be stored, unos dos minutos y medio después de escalar a 0 event-management, el lector que almacena los eventos. El lector no puede reportar mientras está caído, así que esta línea es el recuento del propio broker para los mismos mensajes, y sube a medida que siguen llegando eventos.
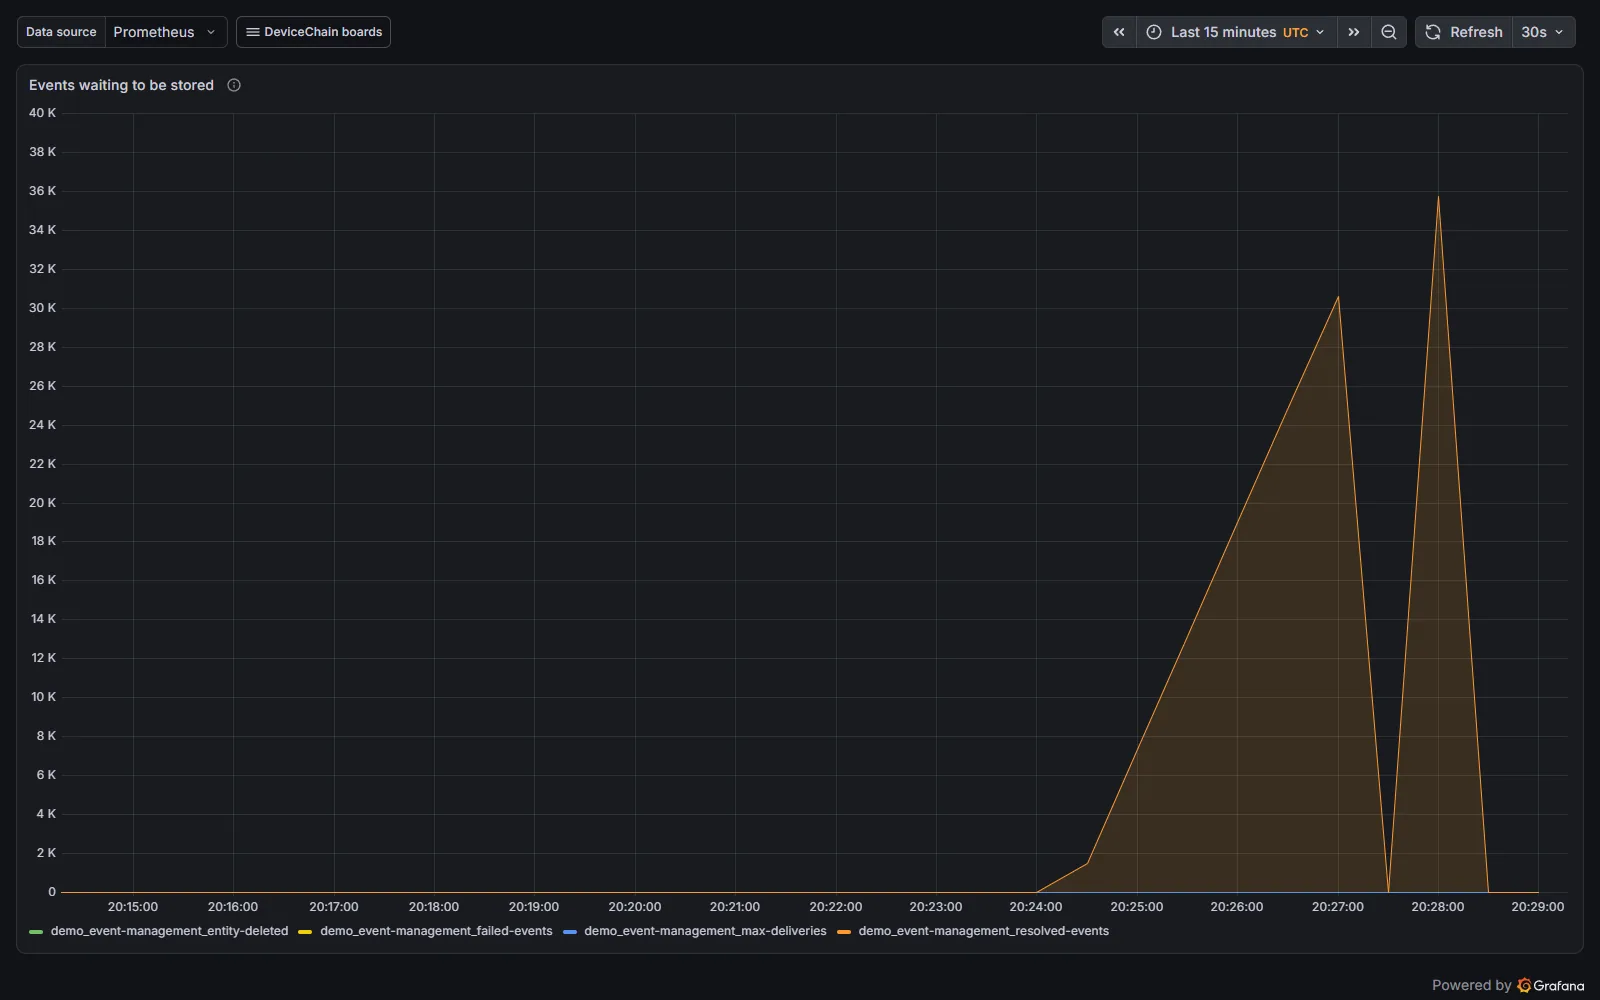
El mismo panel una vez que event-management se volvió a escalar a 1. El retraso se vacía en cerca de un minuto desde que arranca el lector. El respaldo del broker cuenta tanto los eventos en espera como los eventos en vuelo hasta que el lector vuelve a reportar.
Diecinueve paneles tienen la alternativa del broker:
- Messaging: Unread backlog per reader, Handed out, not yet acknowledged y Share of stream capacity left unread.
- Ingest: Backlog against its limit, Backlog and stream fill over time, Arriving vs backlog growth (su línea de crecimiento del retraso) y Capture backlog in messages (su primera línea).
- Event processing: Consumer lag (undelivered), In-flight (delivered-unacked), Consumer backlog, Derived-event backlog y Consumer unread backlog (share of stream capacity).
- Delivery: Waiting to be sent, Dispatch backlog, Notification backlog y Update report backlog.
- Persistence: Events waiting to be stored y Updates waiting to be applied.
- Overview: el indicador Largest backlog share.
Messages waiting to be redelivered, en Messaging, es siempre el recuento del propio broker, así que no tiene una fuente del lector a la que recurrir.
Conviene conocer dos límites:
- La alternativa necesita las métricas del broker. La pila de monitoreo recoge las métricas del broker, así que en una instalación por defecto la alternativa funciona. Si usas tu propio Prometheus sin recoger las del broker, un panel de retraso se queda en blanco cuando su lector se detiene, como antes.
- Los contadores de pérdida no tienen alternativa. Los indicadores y líneas que cuentan los mensajes que el flujo descartó antes de que el lector los leyera los cuenta el propio lector: en Ingest, Messages lost before being read, over the range y …, any consumer y la segunda línea de Capture backlog in messages (la brecha sin leer); en Messaging, Messages lost unread (range) y Messages lost unread /s; y Messages lost del resumen. Mientras el lector está caído, estos indicadores marcan 0, y eso no demuestra que no se haya perdido nada. Los mensajes descartados durante la interrupción se cuentan solo cuando el lector vuelve, como cota inferior y con la hora de su regreso. Durante una interrupción, juzga el riesgo con Share of stream capacity left unread, que sigue funcionando: al 100 % el flujo empieza a descartar mensajes que el lector no ha visto. Consulta Mensajes que un consumidor nunca leyó.
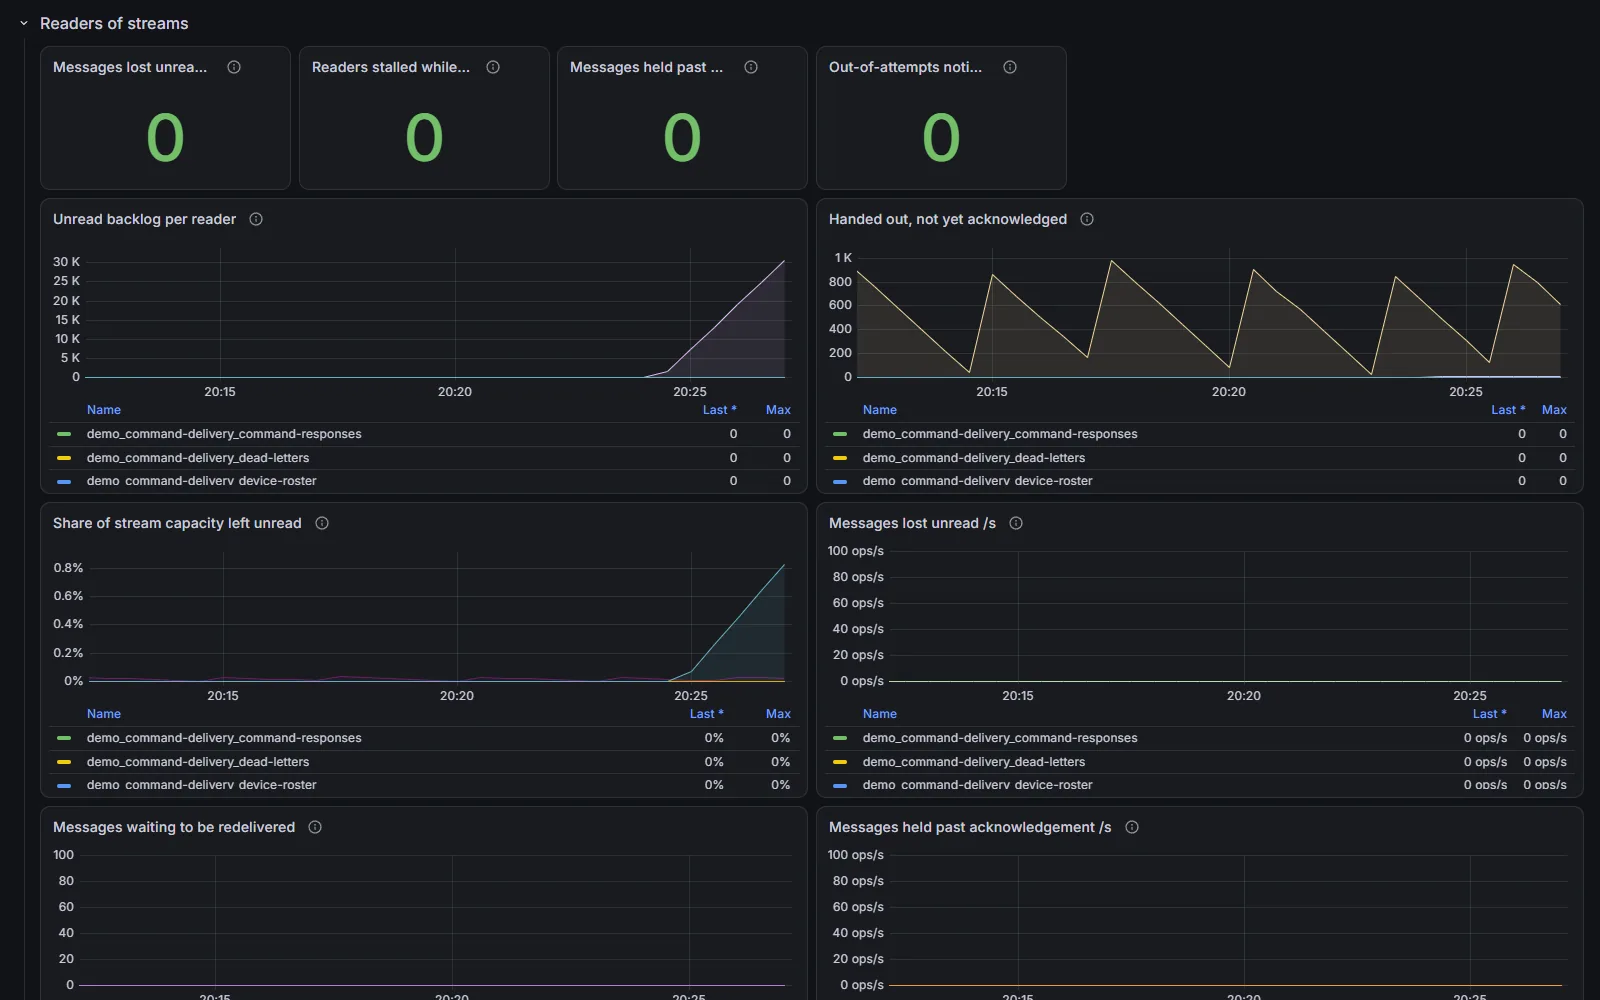
Messaging durante la misma interrupción, en Readers of streams. Unread backlog per reader sube para el lector detenido (la leyenda lista todos los lectores; pase el cursor sobre la línea para ver su nombre), y Share of stream capacity left unread muestra cuánto del límite del flujo ocupa ese retraso: aquí menos del 1 %, lejos del límite.
Una serie ausente significa "no medido", nunca "nada esperando". Si un panel de retraso está vacío, ninguna de las dos fuentes ha reportado: comprueba que el broker se está recolectando (Messaging, Broker servers up) y que existe el durable del lector.
El resumen
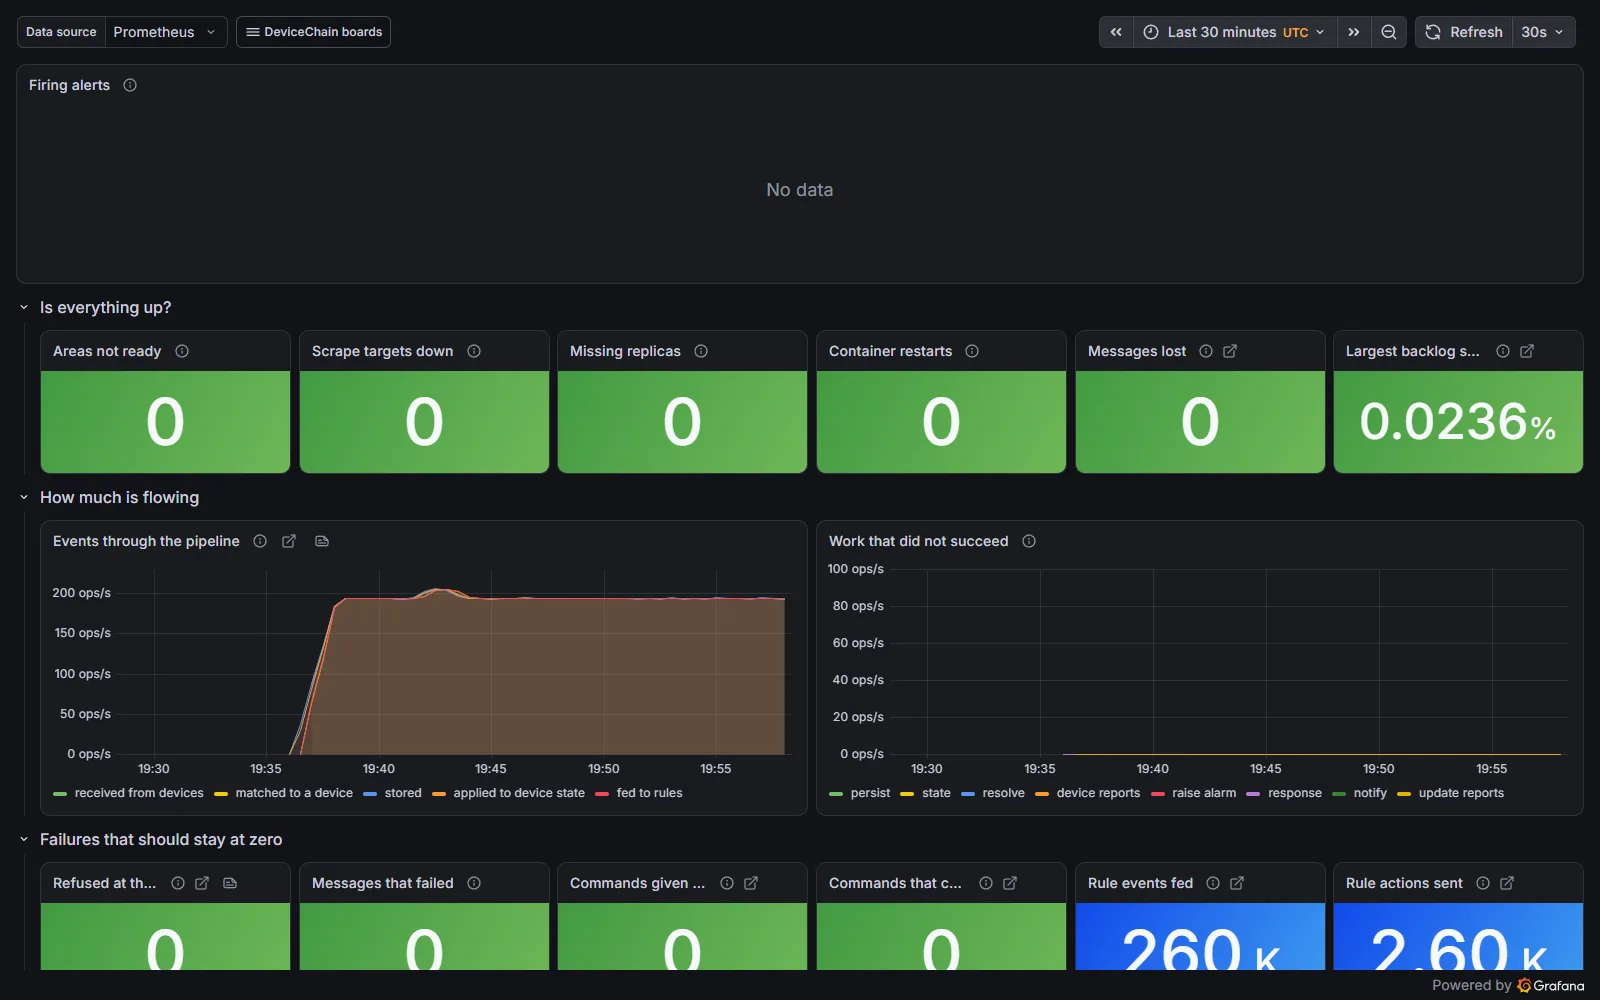
El resumen con una carga constante. Todos los indicadores de Is everything up? están en verde, y las líneas de Events through the pipeline se superponen: los eventos recibidos, asociados a un dispositivo, almacenados, aplicados al estado del dispositivo y entregados a las reglas avanzan al mismo ritmo. La etapa cuya línea se separa de las demás es el panel por etapa que hay que abrir.
Úselo para responder de un vistazo a "¿está todo en marcha y se está perdiendo algo?". Empieza aquí y siga el enlace al panel por etapa de lo que no esté en verde.
| Grupo | Qué muestra |
|---|---|
| Is everything up? | Indicadores de áreas no listas, destinos de recolección caídos, réplicas ausentes, reinicios de contenedores, mensajes perdidos y la mayor cuota de retraso entre todos los lectores. |
| How much is flowing | Eventos a través del pipeline por etapa y trabajo que no tuvo éxito, uno junto al otro para leer una caída frente a la otra. |
| Failures that should stay at zero | Mensajes rechazados en la entrada, mensajes fallidos, comandos abandonados o que no se pueden entregar, y eventos de reglas alimentados frente a acciones de reglas enviadas. Cualquier indicador distinto de cero merece una mirada. |
| Replicas and restarts | Réplicas disponibles por deployment, reinicios de contenedores por pod y los dos indicadores de áreas que se describen a continuación. |
| Stage boards | Enlaces a los siete paneles por etapa. |
Alertas que lo respaldan: todas. Las más importantes para este panel son
InstanceAreaUnavailable e
InstanceContainerRestarted.
Áreas caídas y áreas escaladas a 0
Un área cuyos pods han desaparecido todos deja de reportar nada propio: su disponibilidad, sus métricas, su destino de recolección. Los indicadores Areas not ready y Scrape targets down pueden entonces marcar cero mientras el área no está en marcha en absoluto, porque una serie ausente no es un cero. Dos indicadores leen en cambio los deployments de Kubernetes, que siguen diciendo qué se quiere y qué hay:
| Indicador | Cuenta | Color | Alerta |
|---|---|---|---|
| Areas with no pod available | Áreas y consola que quieren al menos un pod y no tienen ninguno disponible. | Rojo desde 1. | InstanceAreaUnavailable, tras diez minutos. |
| Areas scaled to 0 | Áreas y consola configuradas para ejecutar cero pods. | Azul desde 1. | Ninguna. |
La diferencia es la intención. Un área en cero se redujo a mano
(kubectl scale … --replicas=0), por ejemplo en pausa por mantenimiento, así que se muestra como
un estado propio y no como una caída, y nunca genera alertas. Los dos indicadores nunca cuentan la misma
área. Si un área aparece en Areas scaled to 0 y tú no la escalaste, vuelve a escalarla: no está
sirviendo, y nada te avisará de ello. Los indicadores cuentan las áreas y la consola, que también
es un deployment de la instancia; el pod de depuración del broker de mensajes queda fuera de ambos,
y de la alerta, porque no es un área.
Un área que el perfil de la instancia no ejecuta no tiene ningún deployment, así que no aparece en ninguno de los dos indicadores.
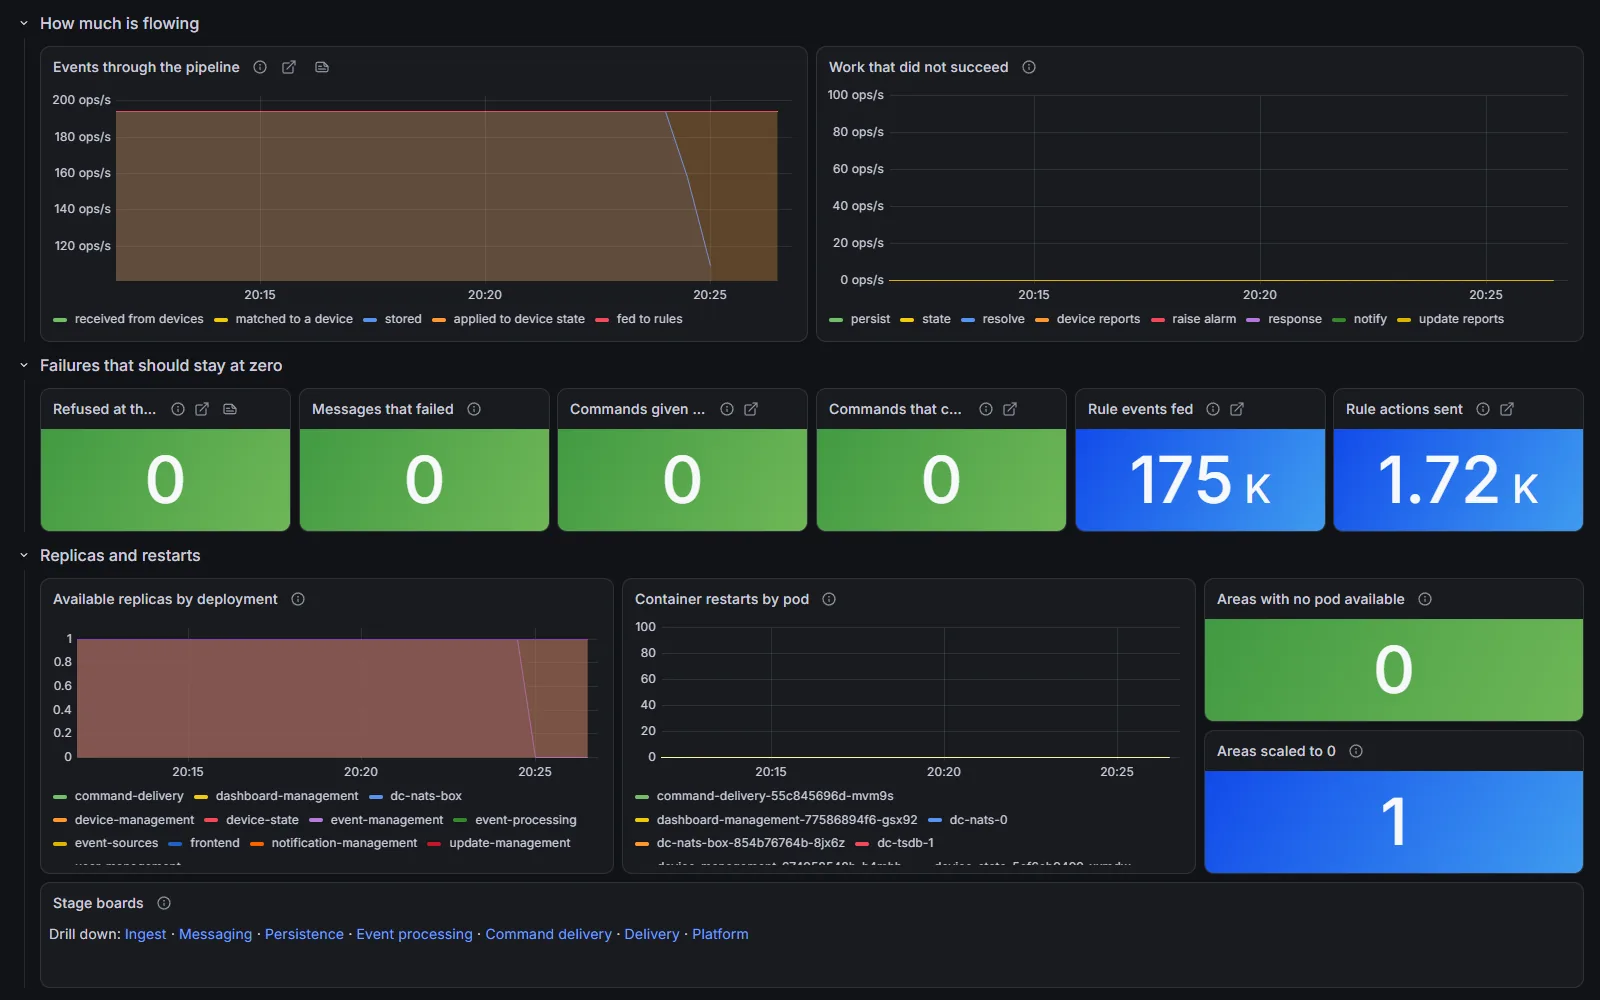
El resumen mientras event-management está escalado a 0. En Events through the pipeline la línea de almacenados cae mientras todas las etapas anteriores mantienen su ritmo. Areas scaled to 0 marca 1, en azul, y Areas with no pod available sigue en 0, porque el área se detuvo a propósito.
Ingest
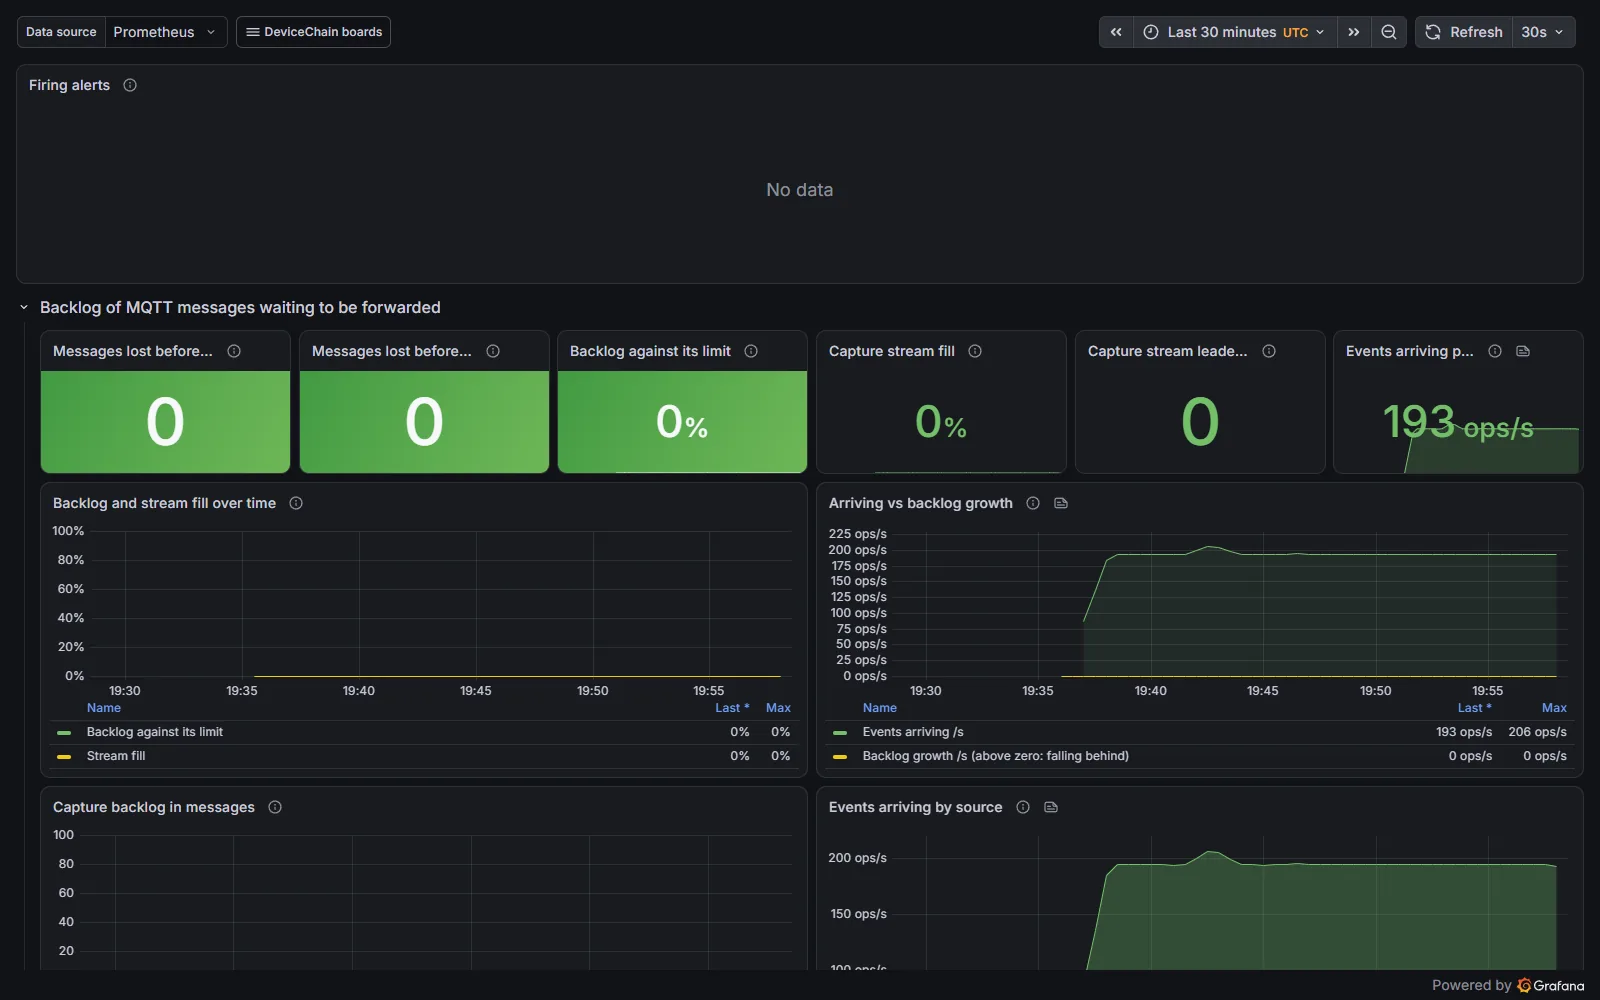
Ingest con la misma carga. Los eventos llegan a un ritmo estable y la línea de crecimiento del retraso de Arriving vs backlog growth se mantiene en cero, así que la instancia va al día; por encima de cero, los eventos llegan más rápido de lo que se reenvían. Aquí los dispositivos envían por HTTP, por lo que el flujo de captura MQTT sigue vacío.
Úselo cuando los eventos no llegan, se rechazan o la ruta MQTT está bajo presión. Cubre la puerta de entrada: lo que aceptan los transportes, lo que rechazan y el retraso de mensajes MQTT aún no reenviados (en espera o en curso).
| Grupo | Qué muestra |
|---|---|
| Backlog of MQTT messages waiting to be forwarded | El retraso del flujo de captura frente a su límite, su ocupación, los mensajes perdidos antes de ser leídos y los cambios de líder. Sus paneles de retraso tienen la alternativa del broker, salvo la línea de brecha sin leer de Capture backlog in messages. Por encima del 10 % y subiendo, añade réplicas de event-sources; al 100 % se descartan los mensajes sin leer más antiguos. |
| Refused or lost at the door | Mensajes rechazados para proteger datos sin leer, retenidos por límites de tasa, rechazados por mal formados, rechazados por un tenant eliminado o por una credencial en el cuerpo MQTT, y publicaciones externas fallidas. |
| Protection of the MQTT message store | Consumidores requeridos presentes, ajustes del almacén restituidos, flujos de pasarela sin límite de tamaño y conexiones rechazadas porque el almacén está lleno u ocupado. |
| Device presence and external sources | Cambios de conexión y desconexión no registrados, fuentes MQTT externas sin exactamente un lector y la caché de inicio de sesión de dispositivos. |
| Device self-registration | Dispositivos registrados, rechazos por motivo y tiempo de respuesta. |
| Sparkplug ingest, LwM2M ingest | Solo cuando se ejecutan esos servicios opcionales: lectores activos o estado de servicio, fallos y tráfico por protocolo. Cada uno tiene su propio panel completo: Sparkplug ingest y LwM2M ingest. |
Alertas que lo respaldan: las alertas de MQTT y del flujo de captura descritas en Contrapresión en la ruta de ingesta y Mensajes que un consumidor nunca leyó, las de fuentes externas en Una fuente MQTT externa que nadie lee, las de registro en Autorregistro de dispositivos y las de caché de credenciales y limitador de tasa, y las de ingesta Sparkplug y LwM2M.
Messaging
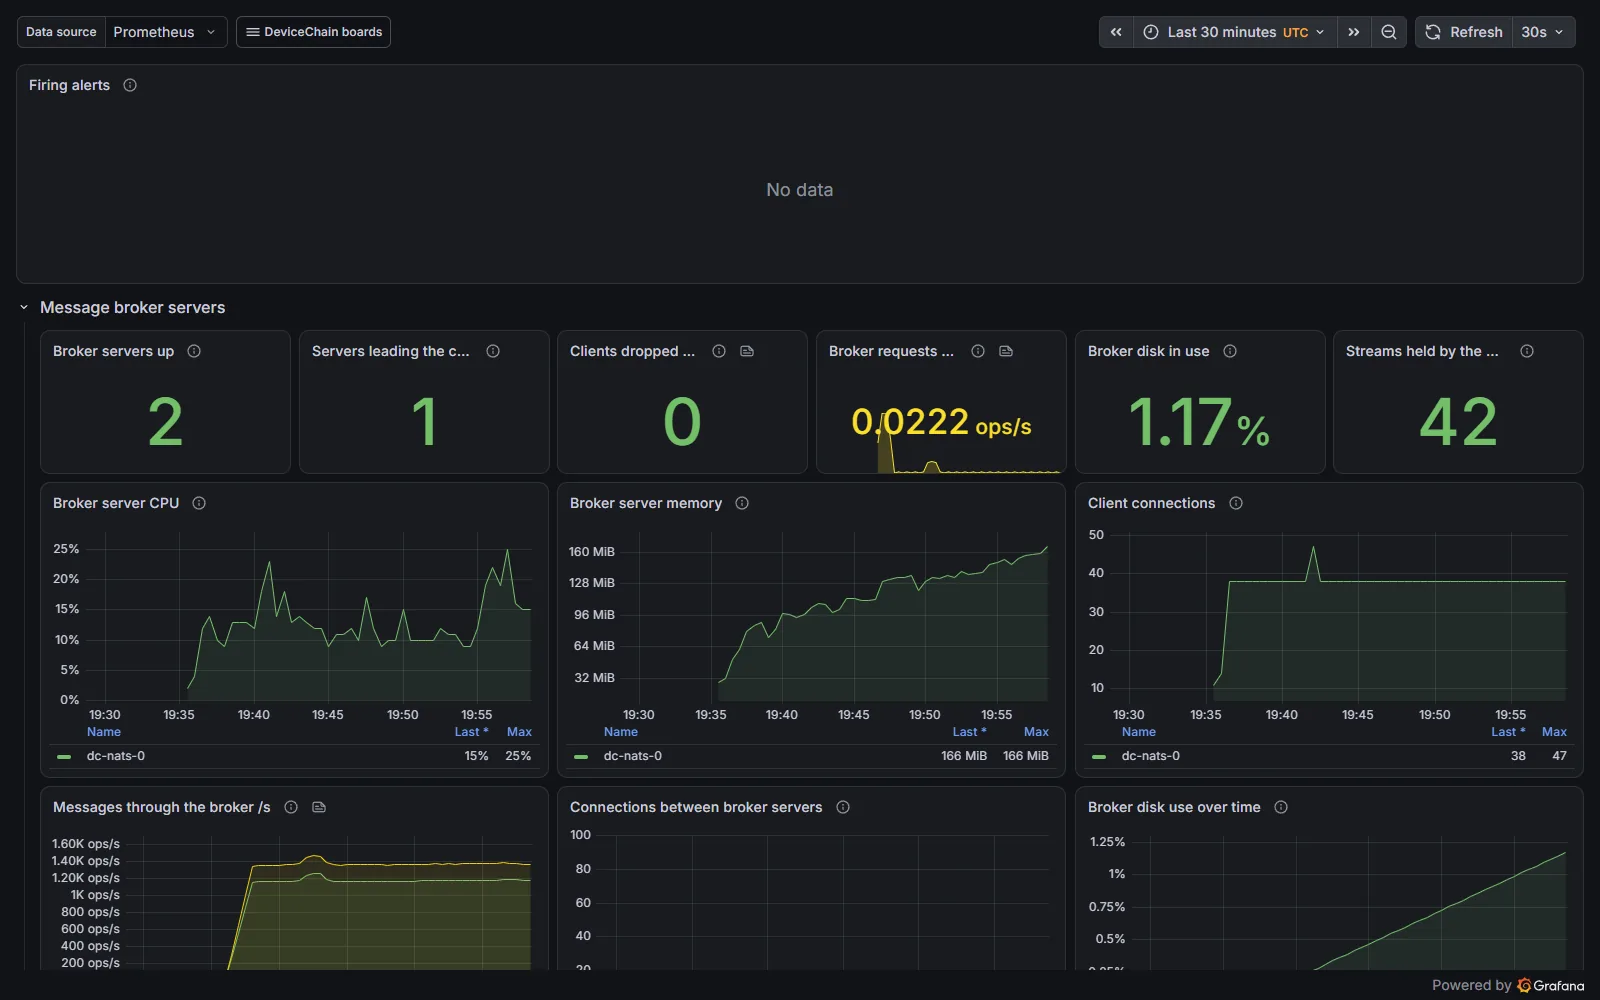
Messaging con la misma carga: los servidores del broker, su CPU, memoria y conexiones de clientes, y los mensajes que pasan por ellos. Cuando algo se acumula y no sabe dónde, el grupo Readers of streams, más abajo, nombra al lector.
Úselo cuando algo va lento o acumula retraso y aún no sabe dónde. El broker de mensajes conecta todas las etapas, así que este panel muestra la infraestructura compartida: los servidores del broker, los flujos que guardan, quién los lee y cuánto se retrasa, y si las copias están sincronizadas.
| Grupo | Qué muestra |
|---|---|
| Message broker servers | Servidores en marcha, quién lidera el clúster, clientes descartados por lentos, fallos de solicitudes, disco, CPU, memoria y conexiones. |
| Streams | Flujos por encima del 80 % de ocupación, flujos que rechazan eventos nuevos, ocupación por tamaño y por número de mensajes, y los flujos mayores en disco. |
| Readers of streams | Retraso sin leer por lector, mensajes entregados y sin confirmar, cuota de capacidad del flujo sin leer, mensajes perdidos sin leer y mensajes retenidos más allá de su confirmación. La alternativa de retraso se aplica a los tres primeros. |
| Publishing and backpressure | Eventos rechazados por contrapresión, tiempo de publicación y la proporción de tiempo que los publicadores esperan al broker. |
| Copies and leaders | Flujos con menos copias de las configuradas o con copias desactualizadas, cambios de líder de flujo y qué servidores lideraron el almacén de la pasarela MQTT. |
| Failed deliveries and dead letters | Mensajes que agotaron sus intentos de entrega, dead letters guardados, no guardados o perdidos, y conexiones con el broker que murieron en silencio. |
| Key-value buckets and caches | Lecturas de caché atendidas desde memoria, memoria usada, expulsiones, fallos y tiempo de operación. |
Alertas que lo respaldan: las alertas JetStream*,
BrokerConnectionDiedSilently,
ReaderHeldMessagePastAckWait,
MaxDeliveryRecordsWaiting,
ReplayCoveredDeliveriesExhausted,
BrokerPresenceLosingTransitions, las alertas de
replicación y las de dead letters.
Persistence and state
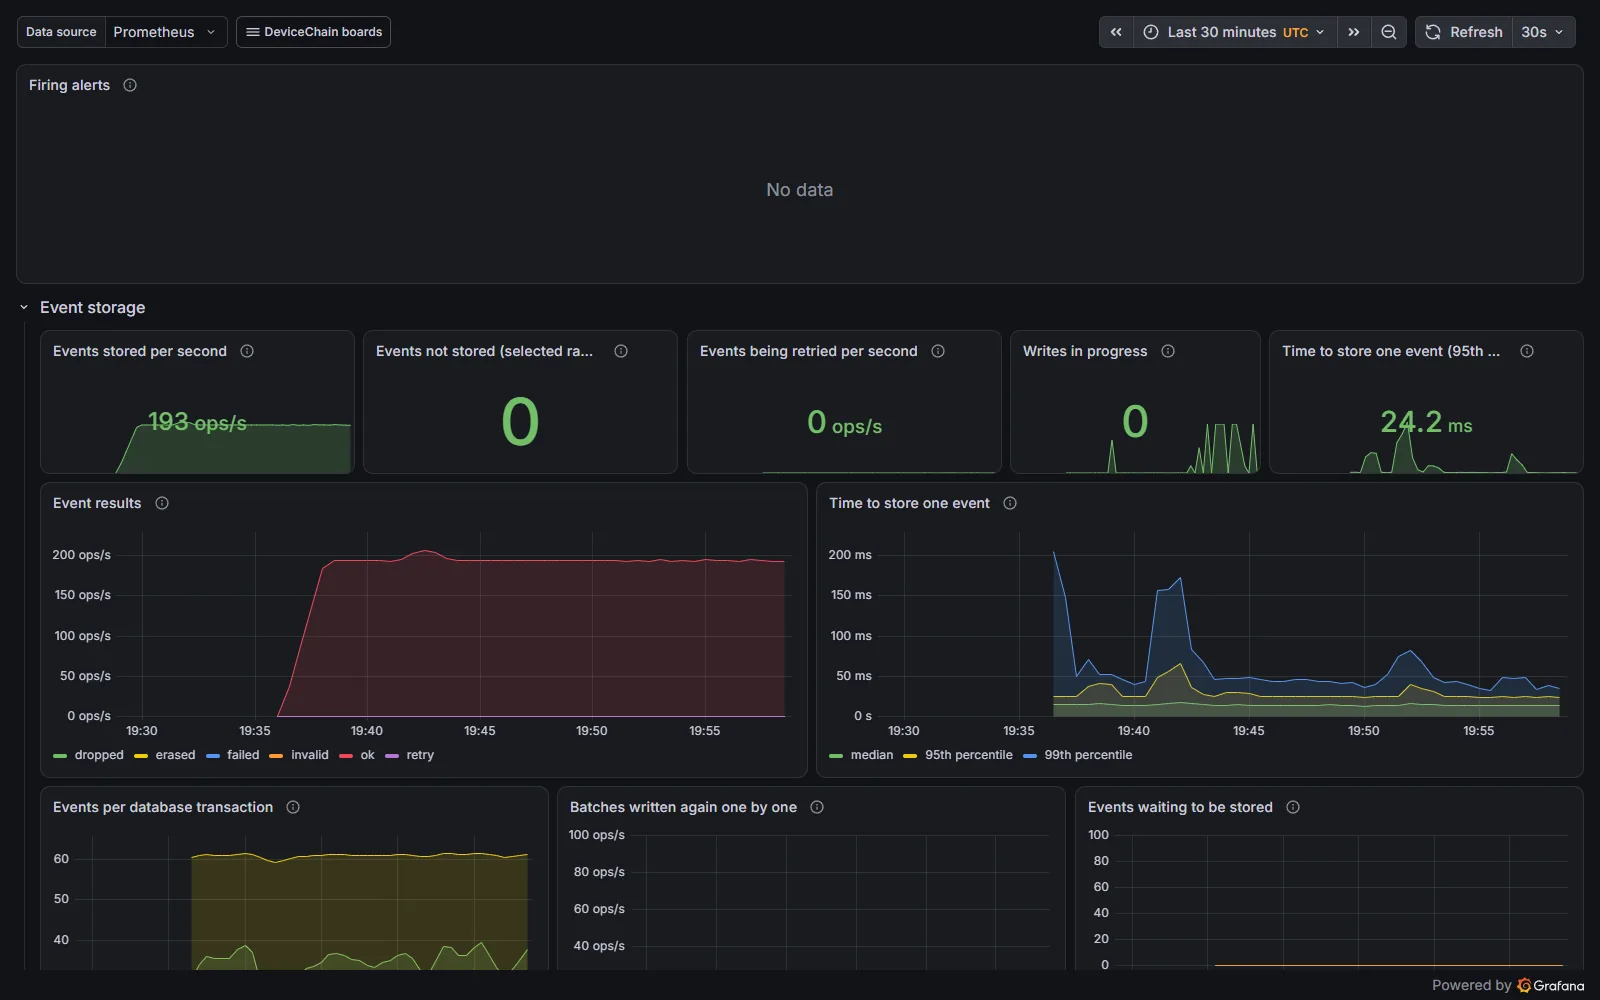
Persistence con la misma carga. Events stored per second coincide con el ritmo de llegada de Ingest, Events not stored es 0, el percentil 95 del tiempo para almacenar un evento está en decenas de milisegundos y Events waiting to be stored (abajo a la derecha) se mantiene plano en cero.
Úselo cuando los eventos se aceptan pero no aparecen, o el estado vivo de un dispositivo está desactualizado. Sigue un evento hasta el almacén de eventos y el estado vivo del dispositivo, y después examina las bases de datos que hay debajo.
| Grupo | Qué muestra |
|---|---|
| Event storage | Eventos almacenados por segundo, eventos no almacenados, reintentos, escrituras en curso, tiempo de almacenamiento de un evento, eventos por transacción y eventos a la espera de ser almacenados (con la alternativa de retraso). |
| Live device state | El mismo conjunto para la proyección del estado de dispositivo: actualizaciones por segundo, perdidas, reintentadas, tiempo por actualización y actualizaciones a la espera de aplicarse (con la alternativa). |
| Background jobs in the event store | Tiempo desde la última reparación del historial, reconstrucciones de métricas calculadas, y tiempo y colisiones de la actualización de agregados. |
| Databases | Estado del servidor y del clúster, réplicas en streaming, conexiones, transacción abierta más larga, commits y rollbacks, tamaño, retraso de réplicas y qué pod es el primario. |
| Write-ahead log and backups | Segmentos de log a la espera de enviarse, fallos de envío, tiempo desde el último segmento enviado y antigüedad de la copia base más reciente. |
| Disk space | El disco de base de datos y el de copias más llenos, el menor tiempo hasta que se llene el disco del almacén de eventos y las tablas de historial mayores. |
| Tenant removal | Eliminaciones en curso, la eliminación abierta más antigua, finalizaciones y fallos, y los almacenes que retienen una eliminación. |
La base de datos relacional y el almacén de objetos de copias de seguridad viven en un namespace compartido por todas las instancias del clúster. Esos paneles lo indican en sus descripciones y muestran la base de datos compartida, no solo la de esta instancia.
Alertas que lo respaldan: DeviceStateDroppingEvents,
las alertas de archivado de copias y del
plano de control de la base de datos, las alertas de
volumen Database*, BackupDestination* y TenantPurge*.
Event processing
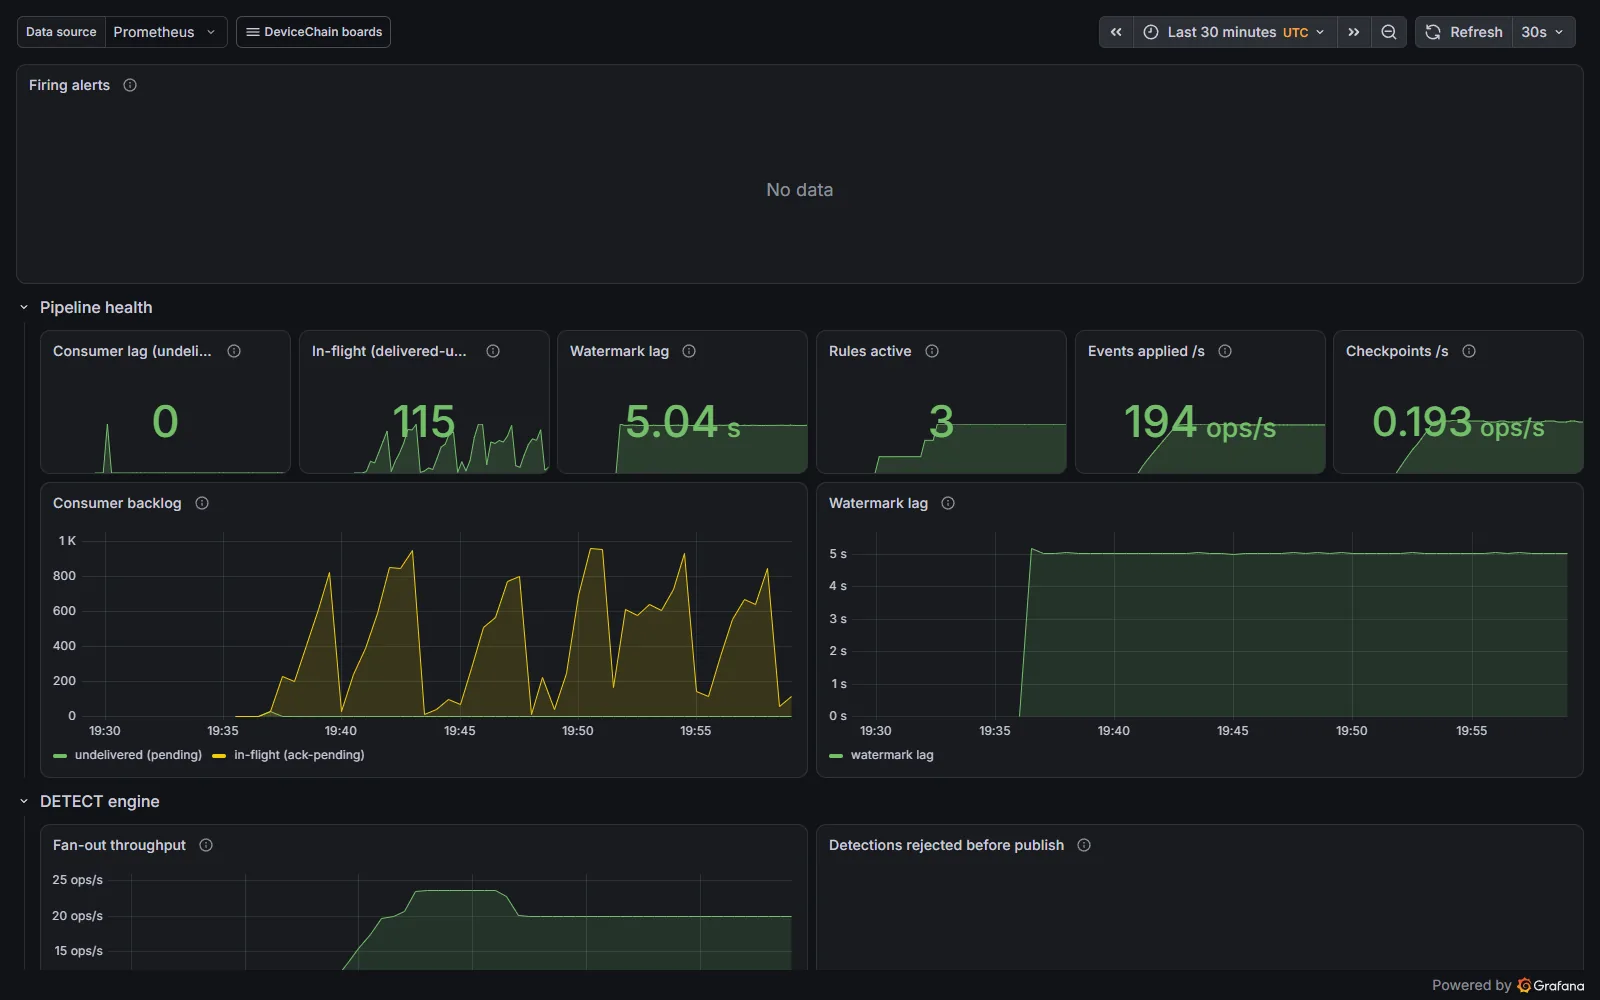
Event processing mientras las reglas generan y resuelven alarmas y envían comandos. Consumer lag es 0, e In-flight sube y baja a medida que los lotes se entregan y se confirman, lo cual es normal con carga. Watermark lag se mantiene estable; una línea que no deja de subir significa que la detección se está quedando atrás respecto del reloj.
Úselo cuando las reglas no se disparan, las alarmas llegan tarde o las reacciones no se ejecutan. Vigila el motor de detección y reacción descrito en Procesamiento de eventos.
| Grupo | Qué muestra |
|---|---|
| Pipeline health | Retraso del consumidor, mensajes en vuelo, retraso de marca de agua, reglas activas, eventos aplicados y checkpoints por segundo. El retraso del consumidor, los mensajes en vuelo y los paneles de retraso del consumidor tienen la alternativa de retraso. |
| DETECT engine | Rendimiento de fan-out, detecciones rechazadas antes de publicar, errores de evaluación y las compuertas de seguridad de descarte de versión. |
| REACT dispatcher | Acciones despachadas, fallos de despacho, retraso de eventos derivados (con la alternativa), concurrencia y retraso de despacho (p50 y p99). |
| State budget | Entradas de estado con clave vivas, y los tenants que superan su presupuesto de reglas, de claves vivas o de muestras retenidas. |
| Snapshot and restore | Coste de checkpoint, tamaño de snapshot y coste de restauración al arrancar. |
| JetStream streams | Ocupación del flujo y proporción sin leer de la capacidad del flujo para el consumidor. |
| Geofence archive | Geometría de geocercas sin resolver o inconsistente, y la tasa de aciertos, ocupación y expulsiones de la caché de geometría. |
| Rule health and derived publish | Actualizaciones de salud de reglas descartadas, retraso y latencia de escritura, y la proporción de tiempo dedicada a publicar eventos derivados. |
Alertas que lo respaldan: las alertas Detect* y React*, GeoFenceSetPublishFailing y
DeviceFactPublishFailing. Consulta Cómo operar el motor de detección
para saber cómo se ejecuta y se escala el consumidor del motor.
Command delivery
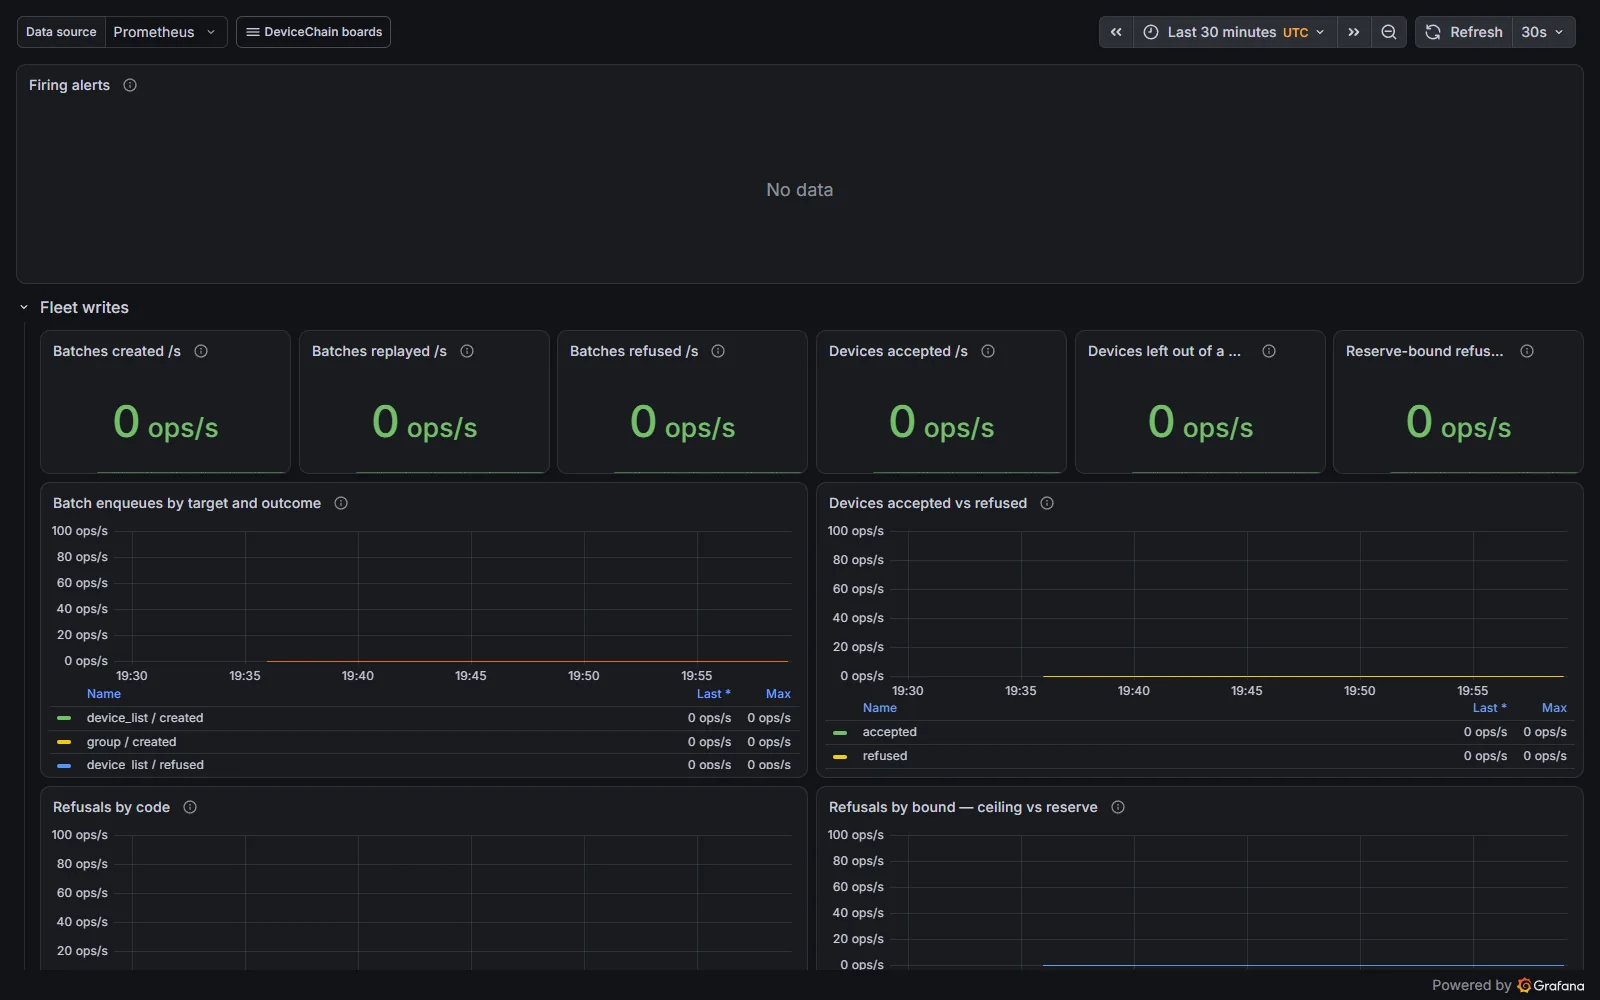
Command delivery mientras las reglas envían comandos que los dispositivos responden. En esta ventana nada escribió a una flota en un solo lote, así que todos los indicadores de escrituras a la flota marcan 0 y los gráficos de rechazos siguen planos. Los comandos que envían las reglas recorren la ruta de despacho; los indicadores Commands given up y Commands that cannot be delivered del resumen marcan 0 para ellos.
Úselo cuando los comandos no llegan a los dispositivos o se rechazan escrituras masivas.
| Grupo | Qué muestra |
|---|---|
| Fleet writes | Lotes creados, repetidos y rechazados por segundo, dispositivos aceptados, excluidos de un lote parcial, y rechazos por código y por límite (techo o reserva). |
| Dispatch | Reclamaciones varadas, reclamaciones perdidas y comandos no entregables. |
| Holds | Retenciones colocadas y liberadas, y errores de lectura de presencia. |
Alertas que lo respaldan: todas las alertas Command*, descritas en
Entrega de comandos.
Delivery
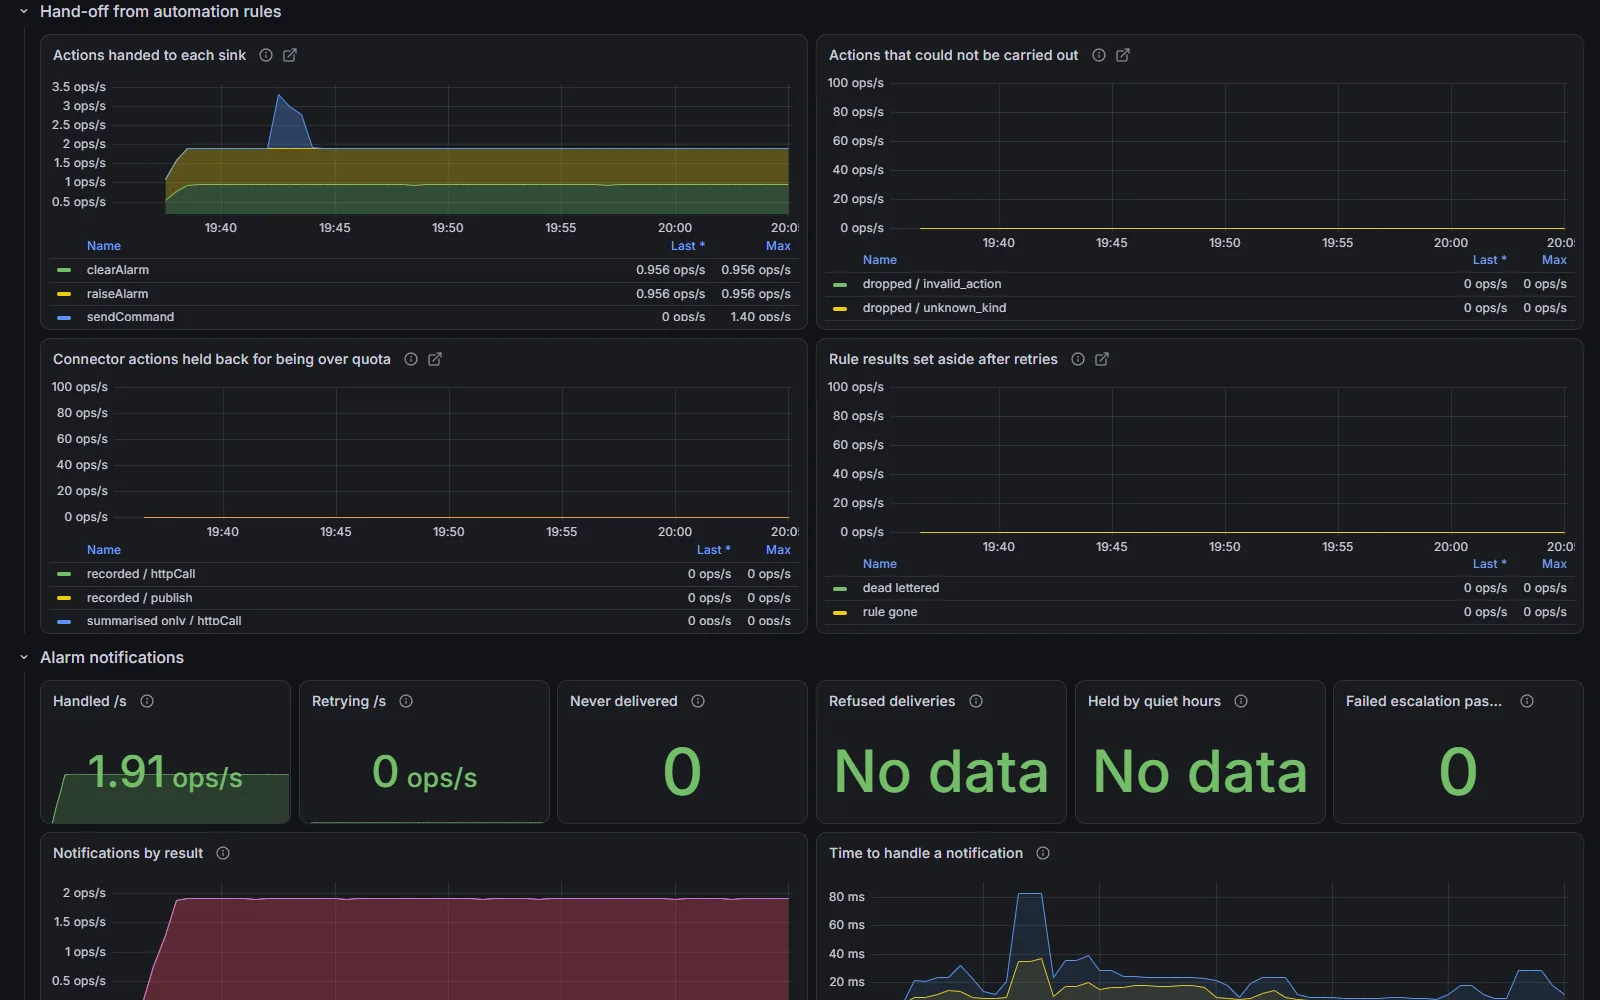
Delivery, abierto en Hand-off from automation rules. Las reglas entregan acciones de generar alarma, resolver alarma y enviar comando a sus destinos, ninguna se rechaza, y las notificaciones de alarma que siguen se gestionan sin reintentos. El primer grupo del panel, los conectores salientes, pertenece a un servicio opcional que esta instancia no ejecuta, por lo que no muestra datos.
Úselo cuando ocurrió una alarma y nadie fue avisado, o cuando un conector o una actualización está atascado. Es el último tramo, desde la reacción de una regla hasta una persona o un sistema externo. Los grupos de conectores y de actualizaciones de software pertenecen a servicios opcionales: en una instancia que no ejecuta uno de ellos, su grupo sigue en el panel y muestra No data.
| Grupo | Qué muestra |
|---|---|
| Outbound connectors | Enviados, reintentando, abandonados, destinos bloqueados y despachos perdidos, por resultado, tipo de conector y motivo de fallo, más el retraso de despacho. |
| Hand-off from automation rules | Acciones entregadas a cada destino, acciones que no se pudieron ejecutar, acciones retenidas por superar la cuota y resultados de reglas apartados tras reintentos. |
| Alarm notifications | Gestionadas, reintentando y nunca entregadas, rechazos, retenciones por horas de silencio, pasadas de escalado, tiempo de gestión y el retraso de notificaciones. |
| Software updates | Informes de dispositivos por veredicto, descargas y concesiones por resultado, avance del despliegue, intentos que dejaron de responder y el retraso de informes de actualización. |
Los cuatro paneles de retraso usan la alternativa del broker.
Alertas que lo respaldan: ConnectorDispatchRateLimited, ReactConnectorEgressShedding y
ReactShedLettersOverBudget. El grupo de notificaciones no tiene alerta propia; léelo en este
panel. El de actualizaciones de software tiene cuatro: UpdateDownloadsNotConfigured,
UpdateReportsMostlyRefused, UpdateRolloutStepsFailing y UpdateAttemptsGoingUnknown.
Platform
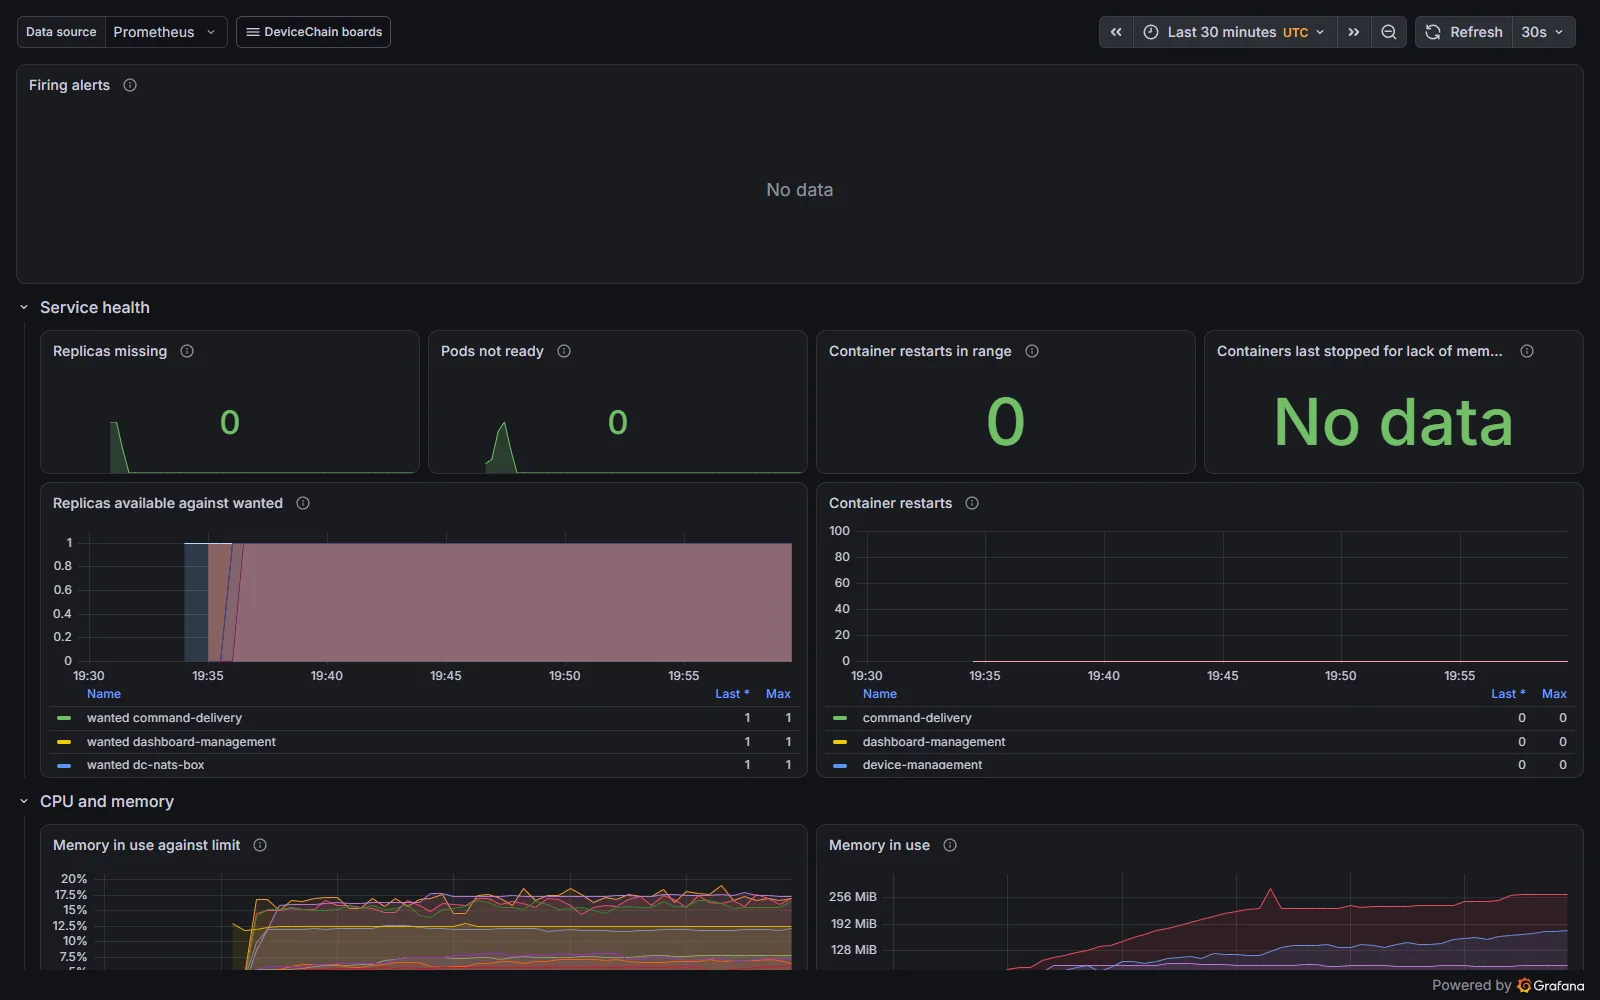
Platform con la misma carga: ninguna réplica falta, ningún pod sin estar listo, ningún reinicio, y las réplicas disponibles de cada deployment iguales a las que quiere. Memory in use against limit, abajo, es el panel que conviene leer antes de cambiar los límites de un servicio.
Úselo cuando un servicio parece poco sano y necesita saber si es el servicio o el nodo que tiene debajo. Es el único panel que trata de los procesos y no del flujo de mensajes.
| Grupo | Qué muestra |
|---|---|
| Service health | Réplicas ausentes, pods no listos, reinicios de contenedores y contenedores detenidos por última vez por falta de memoria, con las réplicas disponibles frente a las deseadas. |
| CPU and memory | Memoria frente a su límite, CPU frente a su solicitud y limitación de CPU. |
| Service runtime | Goroutines, heap, memoria residente, ejecuciones y pausas del recolector de basura, y manejadores de archivo abiertos frente al límite. |
| Sign-in | Comprobaciones de credenciales por resultado, inicios de sesión limitados, rechazos de inicio de sesión único, fallos al obtener datos del proveedor de identidad y obtenciones de claves de token. |
| Tenant deletion | La misma vista de eliminación que en Persistence, desde el lado de la plataforma. |
| Limits and safety gates | Compuertas de seguridad desactivadas, tenants medidos con el valor por defecto de la plataforma, asignación compartida en uso, acciones salientes descartadas, y los techos alcanzados por el tráfico de dispositivos y por las llamadas salientes. |
| AI inference | Llamadas de inferencia por resultado y tokens de modelo usados. |
Alertas que lo respaldan: InstanceContainerRestarted,
las alertas Sso* y de almacén de credenciales, TenantPurge*,
SafetyGateDisabled y
TenantsMeteredAtPlatformDefault, RateLimiterOverflowInUse,
RateMeteringClockFallback, ReactShedLettersOverBudget y ConnectorDispatchRateLimited.
Sparkplug ingest
Úselo cuando los nodos Sparkplug dejan de reportar, o cuando el host Sparkplug no está leyendo. Sigue un transporte desde la conexión con el broker hasta las lecturas almacenadas y los comandos enviados de vuelta a los nodos de borde. El servicio es opcional: en una instancia que no lo ejecuta, todos los paneles muestran «sin datos» o cero.
| Grupo | Qué muestra |
|---|---|
| Is it reading? | Lectores activos (exactamente uno es lo sano), fallos de conexión con el broker, suscripciones de grupo rechazadas, mensajes descartados, mensajes que no se pudieron decodificar y nodos que no logran registrarse. |
| What arrives | Mensajes por tipo, y las lecturas, los cambios de presencia y los dispositivos registrados que produjeron. |
| What was not stored | Lecturas omitidas por motivo, y todo lo descartado: en la ingesta, sin decodificar, de dispositivos desconocidos, de un tenant en eliminación, demasiado antiguo y recortado por el límite de un tenant. |
| Presence and rebirths | Solicitudes de rebirth y las descartadas, sondeos de vida y los dispositivos que marcaron como desconectados, recuperación de registro, y cuánto dura una pasada del sondeo y cuándo se ejecutó la última correcta. |
| Commands to edge nodes | Comandos a la espera de un resultado, comandos sin confirmar, fallos de comandos, aperturas del interruptor y las fuentes cuyo interruptor no está cerrado, comandos por resultado, tiempo hasta la confirmación y el estado del interruptor de cada fuente. |
Alertas que lo respaldan: las alertas SparkplugIngest* y SparkplugCommand* de
Ejecución de los servicios de borde.
LwM2M ingest
Úselo cuando no se puede alcanzar a los dispositivos LwM2M, dejan de reportar o sus comandos no llegan. Cubre el servidor CoAP y DTLS, la flota que mantiene, las lecturas que almacena y la ruta de comandos hacia los dispositivos. El servicio es opcional: en una instancia que no lo ejecuta, todos los paneles muestran «sin datos» o cero.
| Grupo | Qué muestra |
|---|---|
| Is it serving? | Líderes y réplicas sirviendo (exactamente una de cada), notificaciones descartadas, comandos no ejecutados, handshakes rechazados y sesiones rechazadas por el límite. |
| The fleet it holds | Registros, sesiones y observaciones, el ciclo de vida de los registros, marcas de conmutación por error, registros rechazados, handshakes DTLS y solicitudes del sondeo de salud. |
| Readings | Notificaciones y lecturas almacenadas, notificaciones que no produjeron lectura, registros no numéricos, todo lo descartado y dispositivos creados por telemetría. |
| Commands | Comandos despachados por operación, comandos apartados y por qué, comandos para dispositivos sin conexión o ajenos, fallos de comandos y el vaciado del retraso. |
| Device information and housekeeping | Recopilaciones de información de dispositivos y sus problemas de escritura, y el barrido que elimina los registros de los tenants eliminados. |
Alertas que lo respaldan: las alertas Lwm2mIngest* de
Ejecución de los servicios de borde.
Edge agent
El agente de borde se ejecuta en hardware de tus plantas y su endpoint de métricas escucha solo en
la dirección de loopback del equipo. El Prometheus de la instancia nunca lo recolecta, así que el
chart no instala ningún panel para él. El panel es un archivo que importas en el Grafana que lee
tu propio Prometheus: edge-agent.json.
Para usarlo, lleva las métricas de los agentes a un Prometheus. El endpoint de métricas escucha en la
dirección de loopback del equipo (127.0.0.1, puerto local.metricsPort, por defecto 9090), así que el
colector tiene que ser un proceso en el propio equipo: nada fuera de él puede alcanzarlo. Las series de
cada agente deben llevar una etiqueta agent única. El selector, las leyendas y las agrupaciones del
panel la usan, y sin ella las series de equipos distintos tienen etiquetas idénticas y se pisan unas a
otras donde se reciben. Defínela como etiqueta externa en el colector de cada equipo. Con Prometheus en
modo agente:
global:
  external_labels:
    agent: site-berlin-01   # unique per box
scrape_configs:
  - job_name: dc-edge-agent
    static_configs:
      - targets: ["127.0.0.1:9090"]
remote_write:
  - url: https://prometheus.example.com/api/v1/write
Los paneles de proceso del tablero (memoria, CPU, goroutines, archivos abiertos) seleccionan el job dc-edge-agent, así que conserva ese job_name: con otro nombre esos paneles aparecen vacíos.
El puerto por defecto del agente, 9090, es también el puerto de escucha por defecto de Prometheus, así
que cambia uno de los dos: arranca el colector en otro, como abajo, o define local.metricsPort en la
configuración del agente y recolecta ese puerto.
prometheus --enable-feature=agent --config.file=agent.yml --web.listen-address=127.0.0.1:9091
Después, en Grafana elige Dashboards, New, Import, sube el archivo y selecciona ese Prometheus como origen de datos. El panel tiene dos selectores, Agent (cada agente que envía la etiqueta) y Lookback (cuánto tiempo atrás buscar agentes que han dejado de reportar). Una planta que pierde su enlace deja de enviar todo, incluido su propio estado de desconexión, así que los indicadores Known agents reporting y Agents silent y la tabla Agents comparan lo que reporta ahora con lo que se vio en la ventana de lookback. El panel no tiene tabla Firing alerts, porque el agente no distribuye reglas de alerta.
| Grupo | Qué muestra |
|---|---|
| Is every site connected? | La proporción de agentes conocidos que reportan, agentes en silencio y agentes desconectados, el evento más antiguo en el búfer, el búfer más lleno, eventos perdidos por desbordamiento, eventos rechazados, agentes con el puerto local abierto y una tabla con una fila por agente. |
| Connectivity | El enlace con la nube de cada agente a lo largo del tiempo y las publicaciones a la espera de la nube. |
| Store-and-forward backlog | Antigüedad del evento más antiguo en el búfer, eventos en el búfer, búfer usado frente a su límite, ocupación del búfer y eventos perdidos por desbordamiento. |
| Throughput | Eventos leídos para reenviar y confirmados por la nube, reenviados por agente e intentos de reenvío fallidos. |
| Refused and rejected events | Rechazos por motivo, eventos rechazados conservados o sin coincidencia, eventos descartados en el equipo y si el puerto local exige una credencial. |
| The agent process | Memoria, CPU, goroutines y archivos abiertos de cada agente. |
Cada panel lee una serie que el agente exporta. Una prueba en el árbol de código del agente comprueba el archivo contra las métricas reales del agente, de modo que una métrica renombrada rompe la compilación en lugar de dejar una planta con un gráfico vacío.
Lo que los paneles no cubren
- El operador de Kubernetes se ejecuta en su propio namespace. Nada recolecta sus métricas y ningún panel lo muestra, ni siquiera los paneles de réplicas, que solo leen el namespace de esta instancia.
- La tasa de solicitudes HTTP y GraphQL, los errores y la latencia por servicio no se exportan, así que ningún panel los grafica.
- La antigüedad de un evento de extremo a extremo, desde la ingesta hasta su almacenamiento o
detección, no se mide. Los paneles de retraso son un sustituto: un retraso que crece es una
demora que crece. La medida real más cercana de antigüedad es
detect_watermark_lag_seconds, que Event processing muestra como Watermark lag: cuánto se retrasa la marca de agua del motor de detección respecto al reloj. - Los agentes de borde se ejecutan en hardware del cliente y el Prometheus de la instancia no los recolecta, así que ningún panel del chart los muestra. Importa el panel del agente de borde en el Grafana que lee tu propio Prometheus.
Relacionado
- Observabilidad y métricas: qué expone cada servicio y la entrada de runbook de cada alerta mencionada arriba.
- Referencia de métricas: todas las series por servicio.
- Ajustar una instancia: qué cambiar cuando un panel muestra que se alcanza un límite.